
前三篇讲的是 DuckDB 引擎通用的部分。DuckLake 没有自己的线程池,它的每条读写路径都跑在 DuckDB 的调度之上;这一篇逐条列出谁在跑、哪里串行。
5.1 DuckLake 在线程上怎么跑
动画版:
ducklake-engine-animation.html(21 步,按下表逐条走一遍,每步带源码锚点和常见误区)。
全景图:ducklake-thread-model.html(一张图看全:上方 DuckDB 调度层,中间 4 条泳道,红框 = 串行点)。
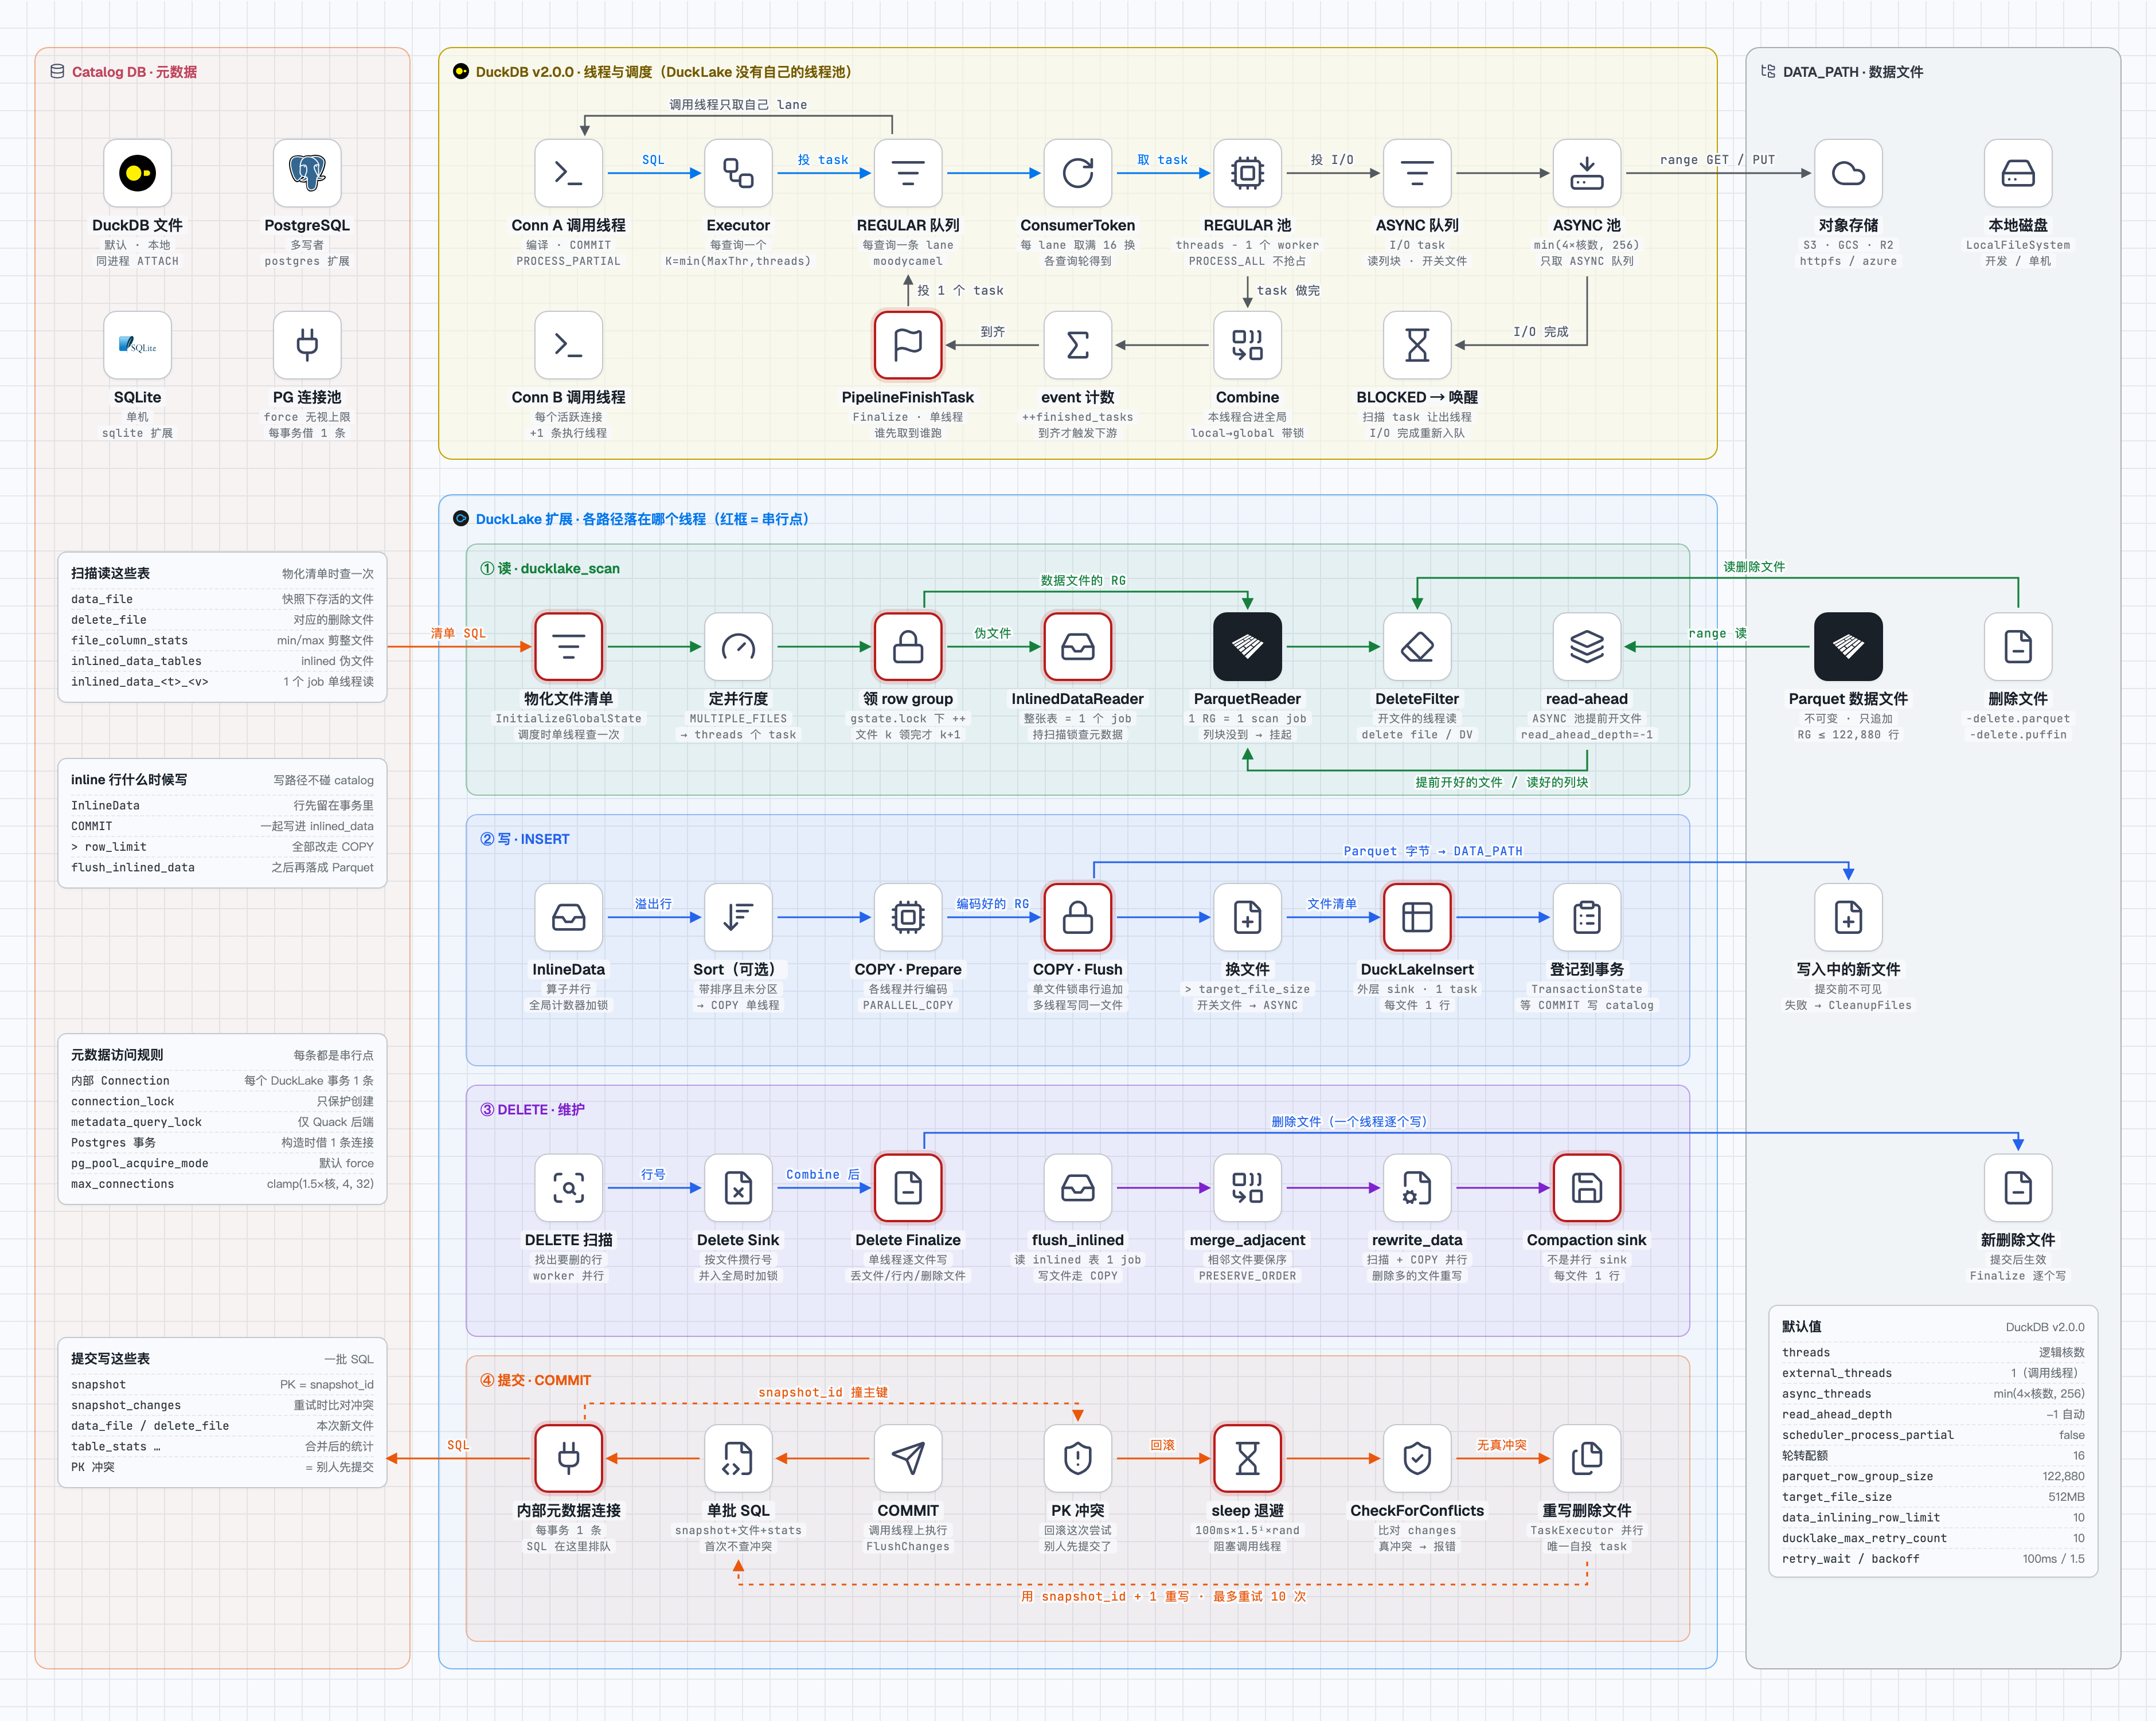
DuckLake 没有自己的线程池,并行度全部来自 DuckDB 的 pipeline 调度;它唯一自己投任务的地方是:提交重试时用 TaskExecutor 并行重写删除文件(SetDeleteCommitSnapshotTask,ducklake_transaction.cpp:746)。下表按路径列出”谁在跑、哪里串行”(DuckLake 源码路径省略 ducklake/src/ 前缀):
| 路径 | 怎么并行 | 串行点 | 源码 |
|---|---|---|---|
读 ducklake_scan |
DuckLake 的文件清单固定报 MULTIPLE_FILES,Parquet 因此不限 MaxThreads → 总是起 threads 个 task(小表也一样,多出来的领不到活就退出);每个 task 每次领 1 个 row group |
领取在扫描全局锁下按文件顺序进行:文件 k 的 row group 全部被领走,才轮到文件 k+1(已领走的可以同时解码) | storage/ducklake_multi_file_list.cpp:443;duckdb/extension/parquet/parquet_multi_file_info.cpp:423、:592;duckdb/src/include/duckdb/common/multi_file/multi_file_function.hpp:678 |
| 文件清单 | — | pipeline 被调度时,在 InitializeGlobalState 里单线程查一次元数据库(谁调度这条 pipeline 谁执行:首批是调用线程,下游是完成上游的那个线程);GetFiles 另有 file_lock 兜底 |
storage/ducklake_multi_file_reader.cpp:288;storage/ducklake_multi_file_list.cpp:825 |
| 删除过滤 | 打开数据文件的线程同步读它的 delete file / puffin DV;开了 read-ahead 时,这个线程就是 ASYNC 池线程 | 每个文件一次 | storage/ducklake_multi_file_reader.cpp:304;storage/ducklake_delete_filter.cpp:139 |
| 行内数据(inlined) | 一张 inlined 表 = 1 个 job,只有一个线程读 | 读它的元数据 SQL 在 TryInitializeScan 里执行,而 DuckDB 调它时持有扫描全局锁,查询期间同一扫描的其它线程领不到活 |
storage/ducklake_inlined_data_reader.cpp:125 |
| 写 INSERT | 两条 pipeline。① 内层 sink = PhysicalCopyToFile:DuckLake 设 rotate=true → DuckDB 把 preserve_insertion_order 置 false → Parquet 选 PARALLEL_COPY_TO_FILE。多线程并行编码(Prepare),在单文件锁下串行追加(Flush),写同一个文件,超过 target_file_size 换下一个。② 外层 DuckLakeInsert 不是并行 sink,但每个文件只处理一行,开销可忽略 |
追加在每个文件的锁下串行 | storage/ducklake_insert.cpp:610;include/storage/ducklake_insert.hpp:165;duckdb/src/execution/physical_plan/plan_copy_to_file.cpp:28;duckdb/extension/parquet/parquet_extension.cpp:868;duckdb/src/execution/operator/persistent/physical_copy_to_file.cpp:4200、:4250 |
| row group 大小 | 写入时由 parquet_row_group_size(默认 122,880)/ parquet_row_group_size_bytes 决定,读取时一个 row group 就是一个领取单位 |
— | storage/ducklake_insert.cpp:613 |
| 带排序的 INSERT | PreserveSortedOrder 让 COPY 走 REGULAR_COPY_TO_FILE:没分区、没开 per_thread_output 时,写 Parquet 只有一个线程 |
整个写文件阶段 | storage/ducklake_insert.cpp:686 |
| 数据内联(InlineData) | 算子并行;全局行数计数器有锁,一旦超过 data_inlining_row_limit,各线程把已缓存的行重新吐给 COPY |
计数器的锁 | storage/ducklake_inline_data.cpp:42、:130 |
| DELETE | Sink、Combine 并行(各线程按文件攒被删行号,flush 进全局时加锁) | Finalize 单线程逐个文件写 delete file(直接调用 Parquet 写函数) | storage/ducklake_delete.cpp:363、:588;include/storage/ducklake_delete.hpp:172 |
| compaction / flush | 扫描和 COPY 部分并行;merge_adjacent_files 合并相邻文件时要保序,走 PRESERVE_ORDER → 批量 COPY |
两者的 DuckLake sink 都不是并行 sink(每文件一行,开销小) | functions/ducklake_compaction_functions.cpp:777;include/storage/ducklake_compaction.hpp:56;include/storage/ducklake_flush_data.hpp:52 |
| 提交 | 在执行 COMMIT 的连接线程上跑(按 DuckDB 提交路径推断);冲突重试的退避用 std::this_thread::sleep_for 阻塞这条连接线程,不占 worker |
整个提交过程 | storage/ducklake_transaction_state.cpp:2801 |
元数据访问的串行点:
- **每个 DuckLake 事务一条内部
Connection**,在connection_lock下惰性创建(storage/ducklake_transaction.cpp:909),所有元数据 SQL 都经ExecuteRaw走这条连接(:1808)。推断:同一事务里多线程同时发的元数据查询会在这条连接的 ClientContext 锁上排队。 - 这条内部连接的查询照样编译成 pipeline、投进同一个 TaskScheduler,和用户查询抢同一批 worker。
metadata_query_lock(递归锁)只有 Quack 后端用(metadata_manager/quack_metadata_manager.cpp:18);DuckDB 文件、SQLite、Postgres 后端不加这把锁。- Postgres 后端:内部连接里的每个 DuckDB 事务,构造时就从连接池借一条 PG 连接(
duckdb-postgres/src/storage/postgres_transaction.cpp:19),见第 5 篇 6.1 节。
第二章小结:结论速查
duplicate()多连接 = 同一实例;单连接一次一条查询;多连接才并行。后台 worker(threads − 1)共用,每个活跃连接的调用线程另外执行自己查询的 task,总吞吐仍被核数封顶。- parse/bind/plan 在调用线程;执行才用共享 worker 池。
- 两个池:REGULAR(
threads个,计算,也顺手做 I/O)+ ASYNC(默认min(4×核数, 256),只做 I/O)。每个池一个 moodycamel 队列,物理上每查询一条 lane。 - worker 用 ConsumerToken 轮转取 task(每条 lane 取满 16 个就整体换 lane)→ 各查询都轮得到;但无优先级 / 无 work-stealing / 不抢占。
- 一条 pipeline 的 task 数 =
min(MaxThreads, threads);sink 不并行就只有 1 个 task。 - morsel = row group(12 万行);拆 row group 只省”输入内存”,GROUP BY/JOIN/SORT 攒的状态才是内存大头,超了 spill。
- Combine 各做各的;Finalize 是**投进 lane 的 1 个
PipelineFinishTask**,谁取到谁跑;同步靠 event 计数,worker 不空等。 - v2.0 扫描默认开 read-ahead(
read_ahead_depth=-1),文件打开和 row group I/O 提前在 ASYNC 池做。 - DuckLake:写不总落 Parquet(inline)、删除=加过滤、扫描前按 stats 剪文件、乐观提交重试。
- DuckLake 线程:无自建线程池;INSERT 的 COPY 并行编码 + 单文件串行追加;带排序的 INSERT 单线程写文件;DELETE 的 delete file 在 Finalize 单线程逐个写;inlined 表 1 个 job 且读元数据时持扫描锁;每事务一条内部元数据连接;提交重试 sleep 阻塞连接线程。
- 引擎不做准入 → 应用层
Semaphore + 超时;K = min(核数/并行度, mem/单查询内存, PG 侧连接预算)。 - Postgres 连接池 per-ATTACH,默认
force模式无视上限、pg_pool_max_connections只管缓存数;旧的pg_connection_limit已弃用。
出处
官方文档(DuckDB lts / DuckLake stable)
- 并发模型:
duckdb.org/docs/lts/connect/concurrency#handling-concurrency - 行组与并行:
.../guides/performance/how_to_tune_workloads#parallelism-multi-core-processing(122,880 行 / row group 级并行) - vector size:
.../internals/vector#data-flow(STANDARD_VECTOR_SIZE=2048) - threads 默认 = # CPU cores:
.../configuration/overview#configuration-reference - OOM 与 spill:
.../guides/troubleshooting/oom_errors、.../how_to_tune_workloads#larger-than-memory-workloads-out-of-core-processing - 连接最佳实践:
.../how_to_tune_workloads#best-practices-for-using-connections - postgres 扩展设置:
.../core_extensions/postgres#settings(文档里的pg_connection_cache、pg_connection_limit在当前源码已弃用,见第 5 篇 6.1 节) - DuckLake 加密:
ducklake.select/docs/stable/duckdb/advanced_features/encryption - DuckLake 事务/时间旅行/冲突:
.../advanced_features/transactions、.../usage/time_travel、.../advanced_features/conflict_resolution - DuckLake 架构/inlining/delete/compaction:
.../specification/introduction#building-blocks、.../advanced_features/data_inlining、.../specification/tables/ducklake_delete_file、.../maintenance/merge_adjacent_files
源码(DuckDB v2.0.0,路径相对 duckdb/)
- 前端在调用线程:
src/main/client_context.cpp:311(CreatePreparedStatementInternal) - 两个池:
src/include/duckdb/common/enums/task_scheduler_type.hpp:15;src/parallel/task_scheduler.cpp:156(ExecuteForever:REGULAR 取两个队列、ASYNC 只取自己的);src/main/config.cpp:706(async_threads默认) - 轮转取 task:
src/parallel/task_scheduler_queue.cpp:16(TaskQueueTraits,配额 16)、Dequeue(try_dequeue(ConsumerToken));third_party/concurrentqueue/concurrentqueue.h:1106(try_dequeue(consumer_token_t&))、:1332(轮转定位)、:292(BLOCK_SIZE=32);改动提交0f67e73fd31(2026-10-09) - 默认值:
src/common/settings.json(external_threads=1、read_ahead_depth=-1、scheduler_process_partial=false);src/main/config.cpp:646(memory_limit 80%) - task 数:
src/parallel/pipeline.cpp:127(TryGetMaxThreads)、:330(LaunchScanTasks) - 调用线程:
src/parallel/executor.cpp:444(ExecuteTask:只取自己 lane、PROCESS_PARTIAL) - Combine/Finalize:
src/parallel/pipeline_executor.cpp:702(Sink::Combine);src/parallel/event.cpp:56(FinishTask计数);src/parallel/pipeline_finish_event.cpp:79(投 1 个PipelineFinishTask) - morsel 游标:
src/storage/table/row_group_collection.cpp:370(NextParallelScan);src/include/duckdb/storage/storage_info.hpp:26(DEFAULT_ROW_GROUP_SIZE=122880) - 多文件扫描:
src/include/duckdb/common/multi_file/multi_file_function.hpp:678(ClaimNextJobInternal,全局锁下按文件顺序领 job)、:842(max_threads = NumberOfThreads);extension/parquet/parquet_multi_file_info.cpp:423(MaxThreads)、:592(TryInitializeScan) - 异步 I/O:
extension/parquet/parquet_reader.cpp:2363、:2488;src/parallel/scan_read_ahead.cpp:144;src/execution/operator/persistent/physical_copy_to_file.cpp:318(生命周期任务走 ASYNC)、:516(Prepare/Flush 注释)、:4200、:4250 - COPY 并行判定:
src/execution/physical_plan/plan_copy_to_file.cpp:28;extension/parquet/parquet_extension.cpp:868(ParquetWriteExecutionMode)
源码(DuckLake / duckdb-postgres):DuckLake 各路径见上文表内锚点;Postgres 连接池见第 5 篇 6.1 节(duckdb-postgres/src/storage/postgres_connection_pool.cpp:49、src/postgres_extension.cpp:176–:256、src/storage/postgres_transaction.cpp:19;默认值在 github.com/duckdb/database-connector @ c305670 的 src/include/dbconnector/pool/connection_pool_config.hpp,本地子模块未检出,经 GitHub 读取)。
DuckLake 扩展侧:
ATTACH 'ducklake:…'→DuckLakeStorageExtension→DuckLakeCatalog/DuckLakeTransaction(每个 DuckDB 事务一个 DuckLake 事务 + 快照);元数据 SQL 走每事务一条的内部连接到 catalog(PG 时即上面的连接池)。