
3. 引擎调度:两个线程池 + 每 pipeline 私有 morsel
DuckDB 的并发调度是两层:
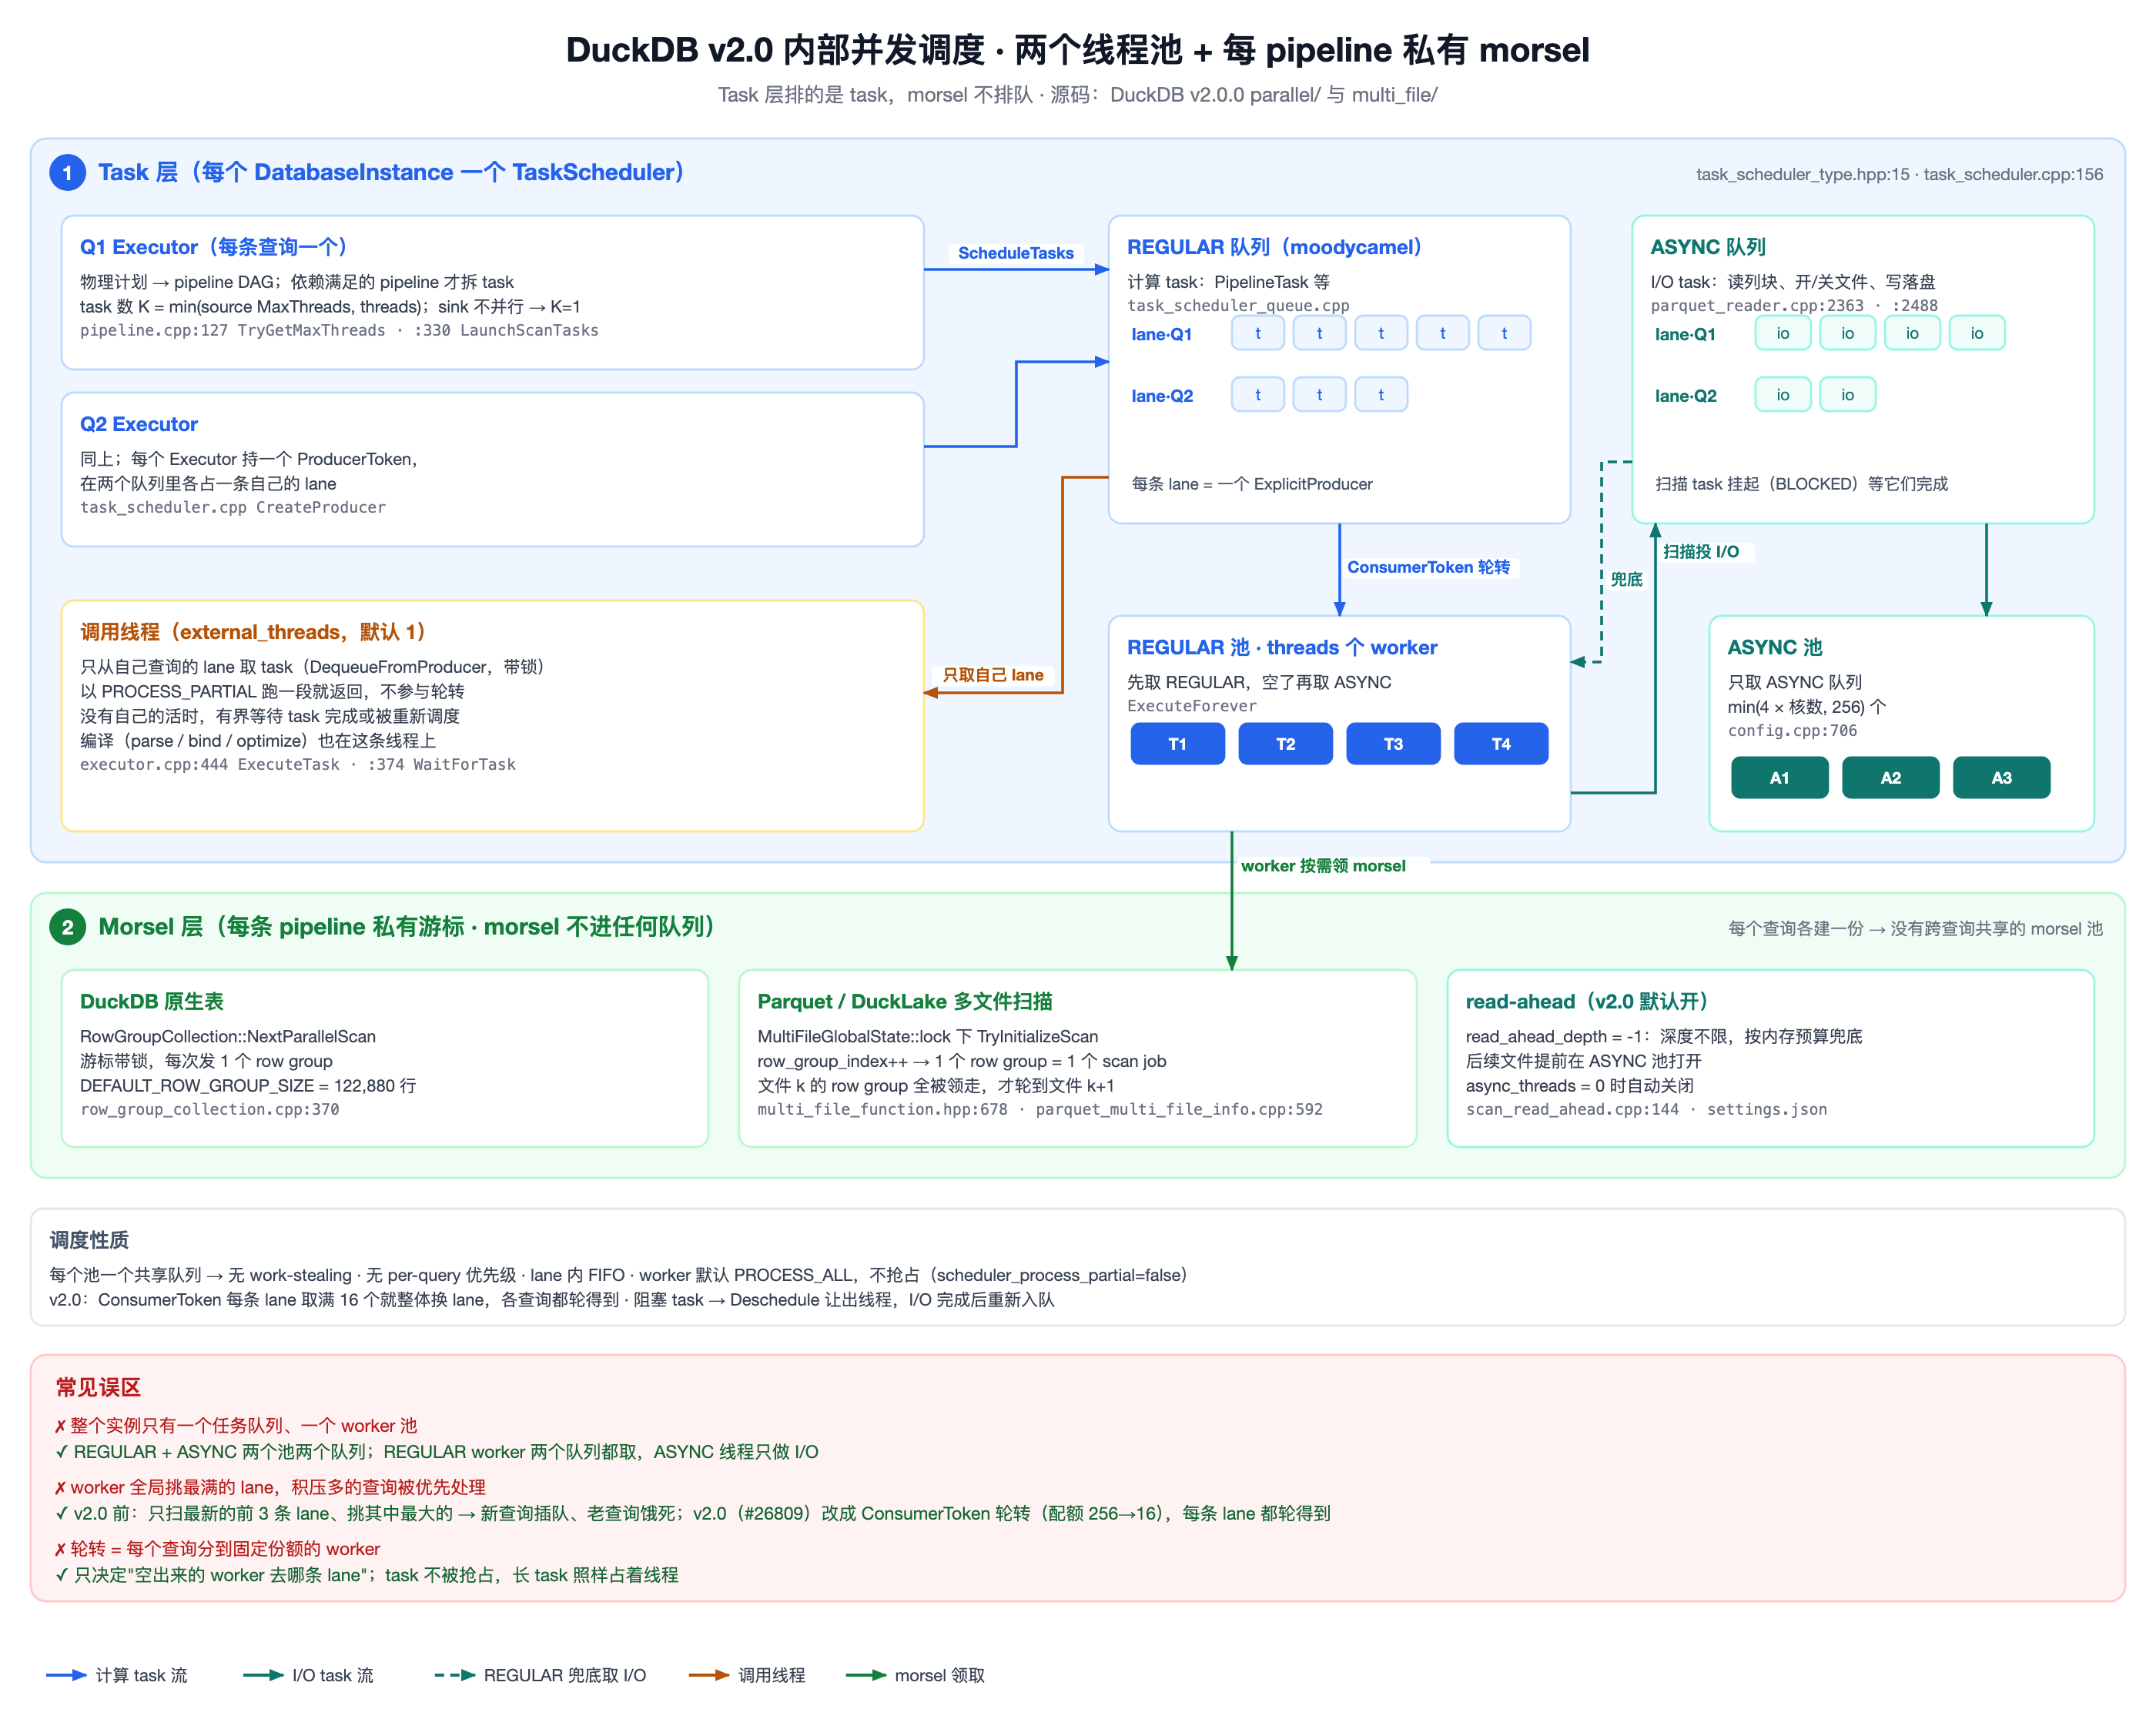
- ① Task 层(全局):每个
DatabaseInstance一个TaskScheduler,内部两个池、两个 moodycamel 队列:TaskSchedulerType { REGULAR, ASYNC }(task_scheduler_type.hpp:15)。- REGULAR 池:
threads个计算 worker。它们两个队列都取:先试 REGULAR、再试 ASYNC(task_scheduler.cpp:156ExecuteForever)。 - ASYNC 池:
async_threads个 I/O 线程,只取 ASYNC 队列。默认async_threads = min(4 × 系统线程数, 256)(config.cpp:706)。 - 队列里排的是 Task,不是 morsel。 每个查询(Executor)有自己的
ProducerToken,在每个队列里各有一条自己的 lane。
- REGULAR 池:
- ② Morsel 层(每 pipeline 私有):morsel 不排队——由每条 pipeline 私有的全局 source 状态(mutex 保护的游标)按需 pull,每次发 1 个 row group。每查询各自建一份,扫同一张表也各自从头发一遍 → 无跨查询 morsel 池。
- DuckDB 原生表:
RowGroupCollection::NextParallelScan(row_group_collection.cpp:370)。 - Parquet / DuckLake:
MultiFileGlobalState::lock下ParquetReader::TryInitializeScan做row_group_index++(parquet_multi_file_info.cpp:592,见第 6 篇)。
- DuckDB 原生表:
调度性质(这几条决定了后面所有稳定性问题):
- 每个池一个共享队列 → 无 work-stealing(没有 per-worker 私有队列);
- 无 per-query 优先级,同 lane 内 FIFO;
- 有 lane 轮转(v2.0 新增):worker 每从一条 lane 取满 16 个 task,就整体轮转到下一条 lane,每个查询都能轮到(3.3);
- 后台 worker 默认
PROCESS_ALL、不抢占(task 跑完或阻塞才让出); - 阻塞 task 由 Deschedule 让出线程,被唤醒后重新入队。
3.1 队列的真实数据结构:lane 本身就是队列
“一个队列”是 API 层的说法;物理上它是一堆 per-producer 子队列的集合(REGULAR、ASYNC 两个队列各是这样一套):
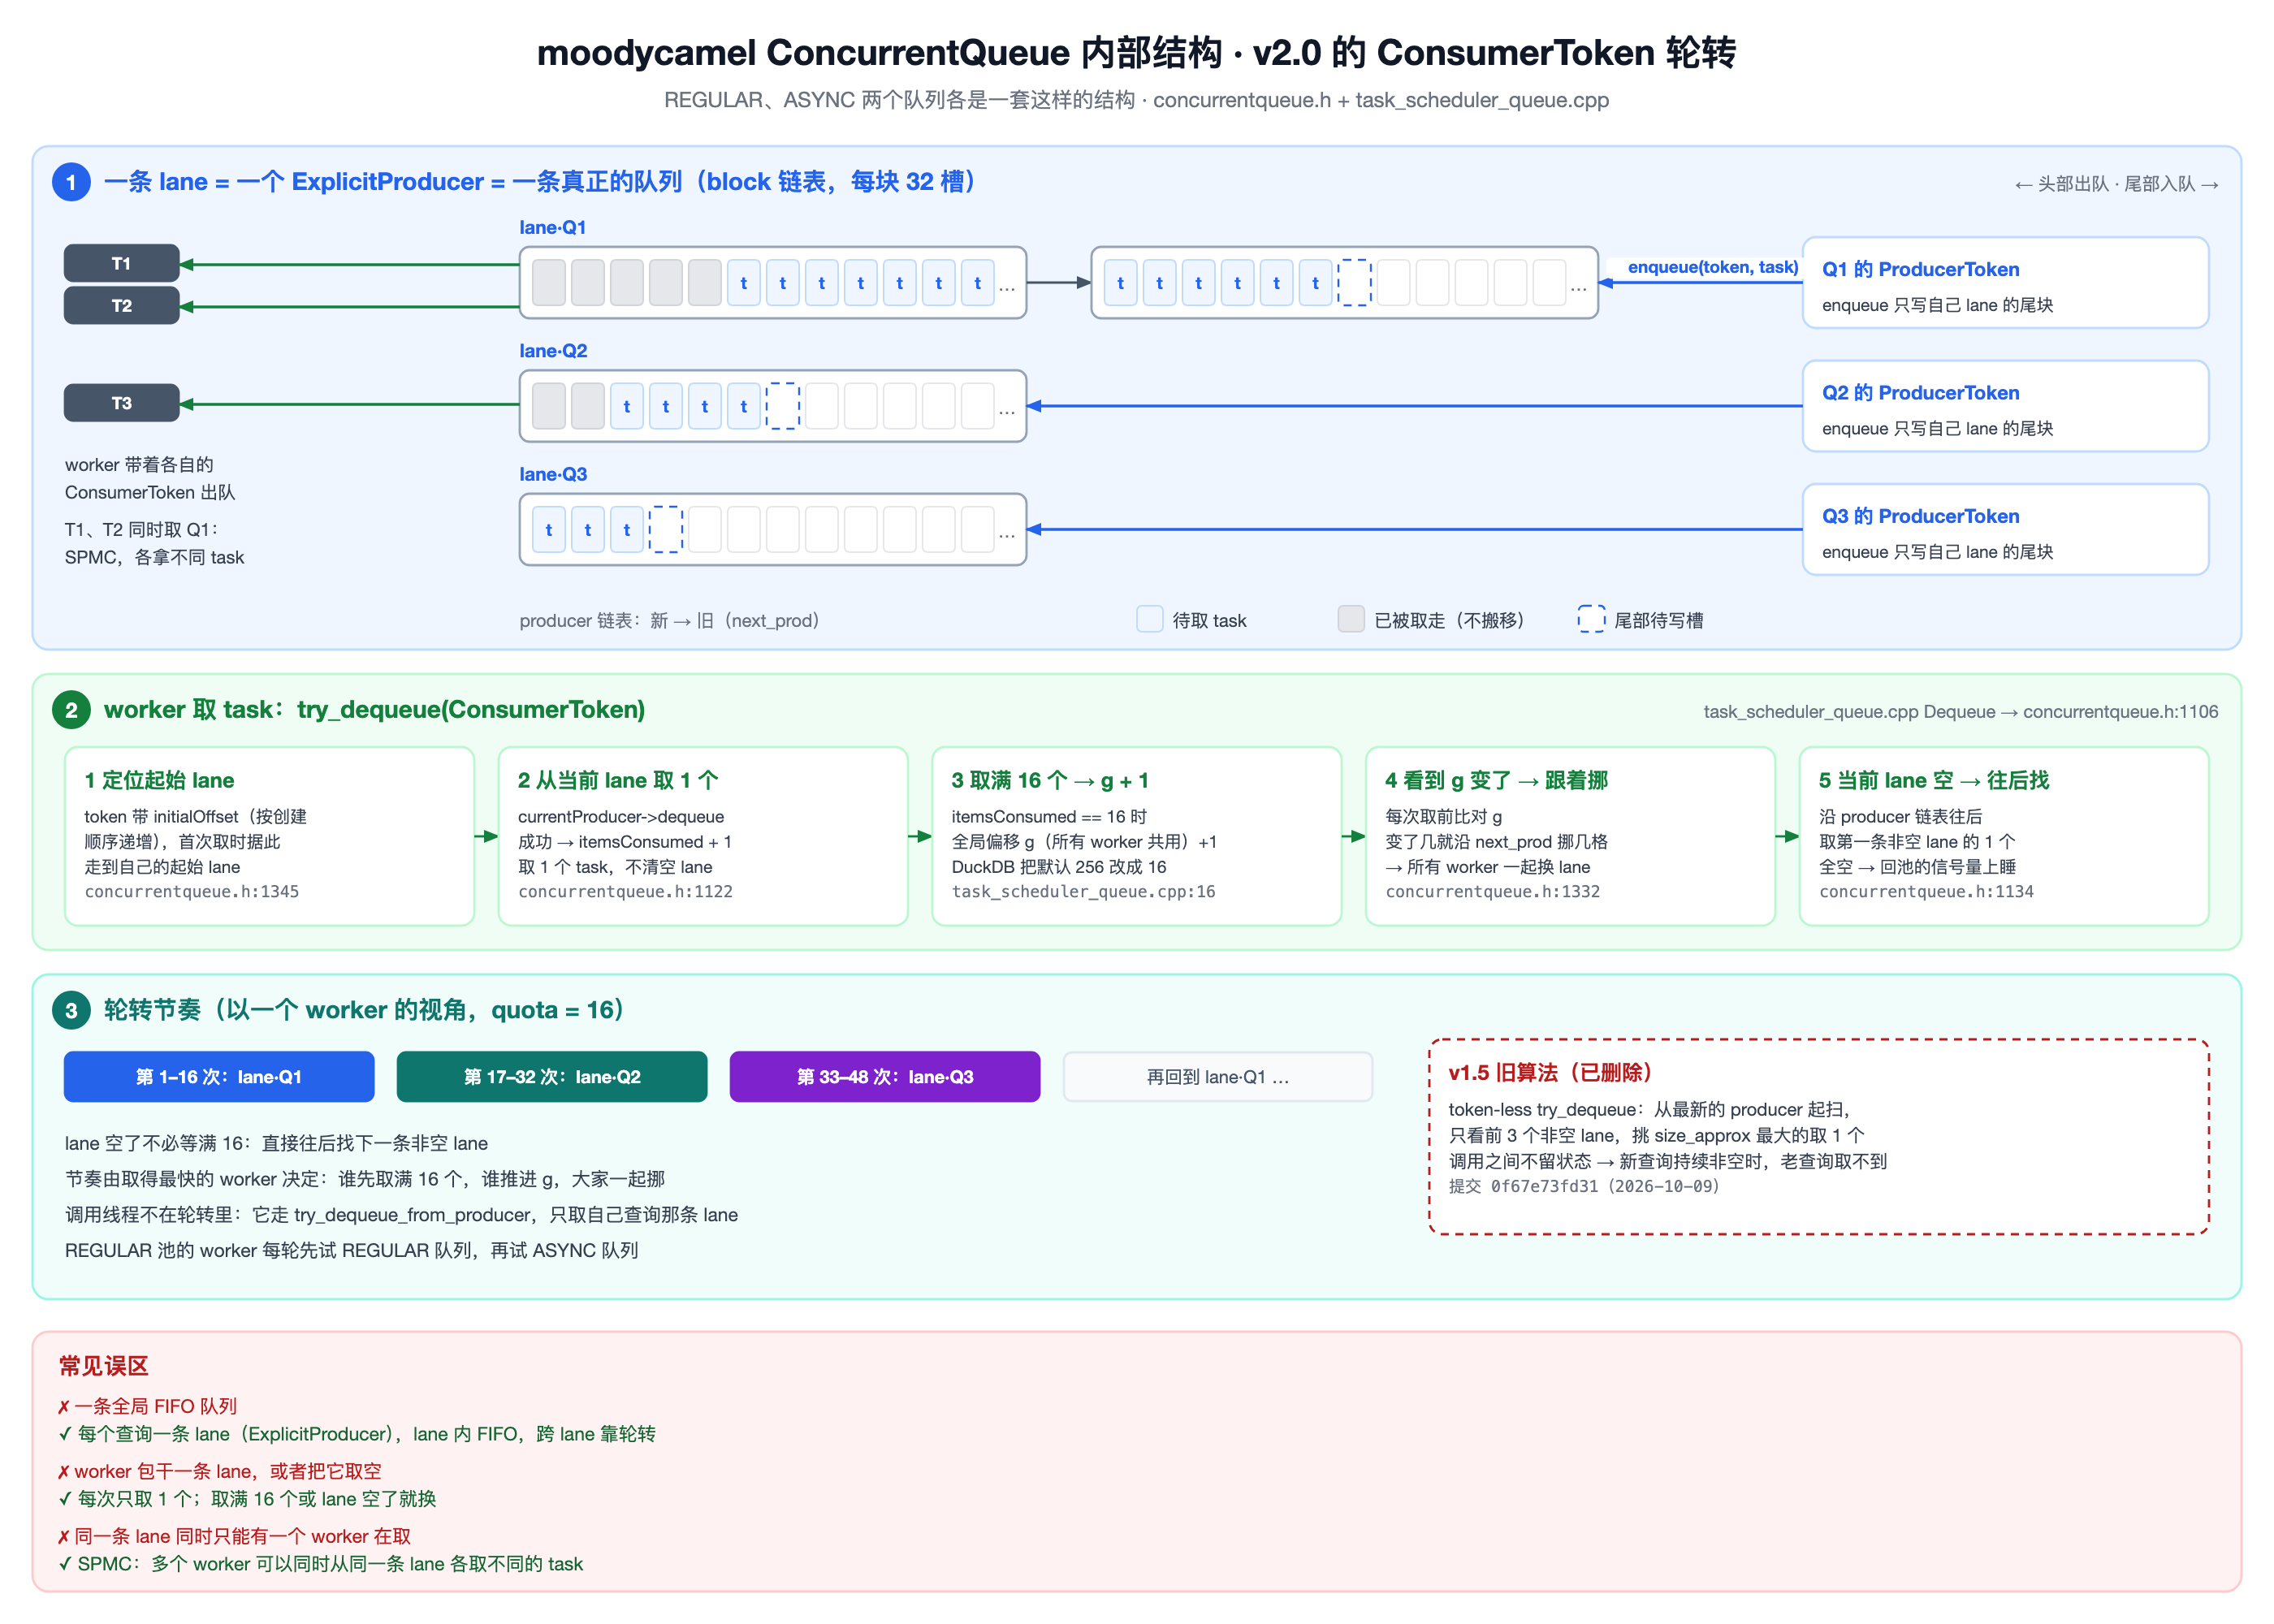
- 一条 lane = 一个
ExplicitProducer= 一条真正的队列(block 链表,每 block 32 槽,concurrentqueue.h:292BLOCK_SIZE=32);SPMC:单生产者塞、多 worker 取。 - enqueue:只往”自己 lane”的尾 block 塞 → 生产者之间零争用、无锁。
- dequeue:worker 带一个 **
ConsumerToken**,从”当前分到的 lane”取 1 个 task;所有 consumer 共享一个全局轮转偏移,任何 consumer 从某条 lane 取满 16 个就推进一次偏移,大家一起换 lane(详见 3.3)。 - 所以”无全局 FIFO / 无 per-query 优先级 / 无 work-stealing”的根源,就是根本不存在一条全局队列,只有一堆子队列 + 消费端轮转遍历。
3.2 多查询怎么在一个 worker 池上交错
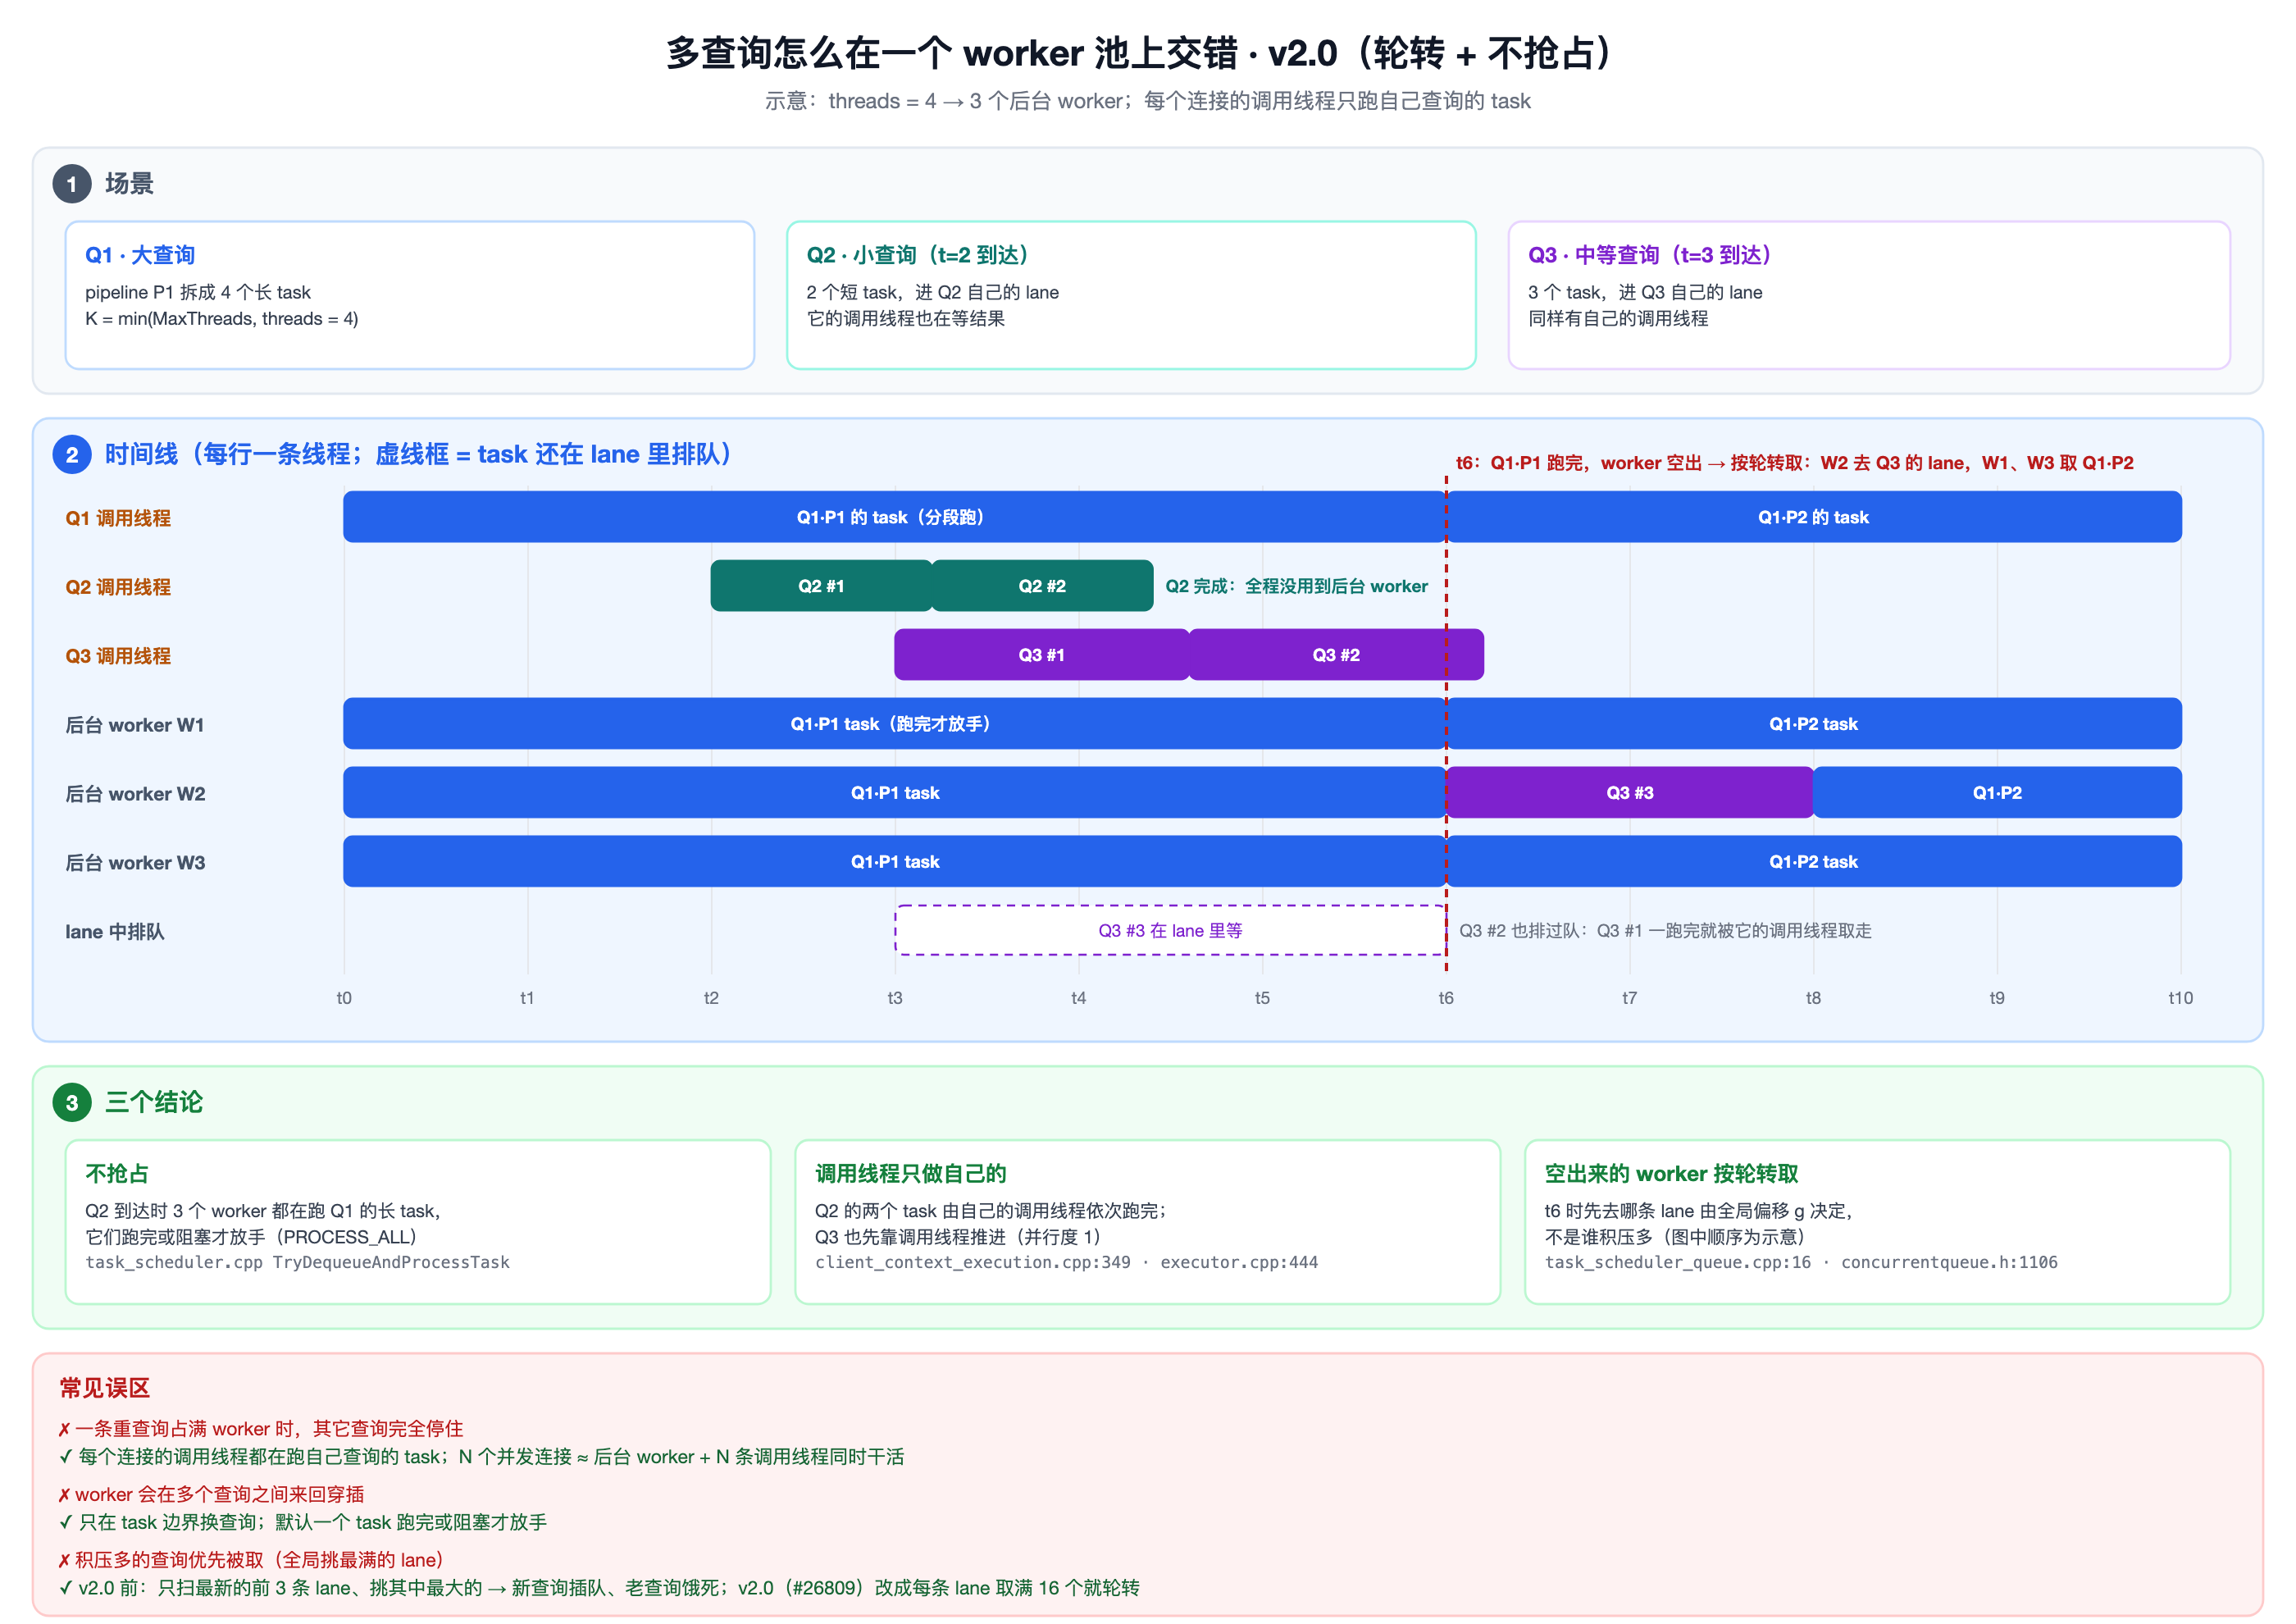
- 调用线程先顶上:新查询到达时就算后台 worker 全忙,它的调用线程也会立刻从自己的 lane 取 task 跑(并行度 1);小查询可能全程只靠调用线程跑完,根本用不到后台 worker。
- **轮转保证”轮得到”**:一个 worker 空出来后,按轮转顺序去下一条非空 lane 取活,所以新查询不会再把老查询的 lane 饿死(v2.0 之前会,见 3.3 末尾)。
- 但不保证”立刻有 worker”:后台 worker 跑
PROCESS_ALL、不抢占。一条重的 CPU 密集查询把 worker 都占在长 task 上时,其它查询的 task 仍要在 lane 里等 worker 空出来。轮转解决的是”空出来的 worker 去哪条 lane”,不是”给每个查询保底几个 worker”。 - 引擎不做隔离和限流——公平/限流仍要在应用层做(见第 5 篇)。
3.3 worker 取 task 的算法:ConsumerToken 轮转(v2.0)
每个 worker 线程在 ExecuteForever 里建一个 ConsumerToken,用 try_dequeue(token, item) 取 task(task_scheduler_queue.cpp 的 Dequeue;moodycamel 实现在 concurrentqueue.h:1106):
- 每个 token 生来带一个
initialOffset(按创建顺序递增),第一次取时据此定位到自己的起始 lane; - 全局有一个
globalExplicitConsumerOffset;任何 worker 从当前 lane 连续取满 16 个 task(DuckDB 把 moodycamel 默认的 256 调成了 16,task_scheduler_queue.cpp:16TaskQueueTraits),就把这个全局偏移 +1; - 每个 worker 取之前发现全局偏移变了,就跟着往后挪同样的格数(
concurrentqueue.h:1332update_current_producer_after_rotation)——所以是”大家一起轮转”,速度由取得最快的 worker 决定; - 当前 lane 空了 → 沿 producer 链表往后找,取第一条非空 lane 的 1 个,并把它设为新的当前 lane;
- 全空 → 返回
false,worker 回到池的信号量(LightweightSemaphore)上休眠等新活。
几点容易记错的:
- 取的仍是一个 task,不是一条 lane;不清空 lane;lane 是 SPMC,多个 worker 可同时从同一条 lane 各取不同 task。
- 调用线程不参与轮转:发起查询的 Executor 用
try_dequeue_from_producer只取自己那条 lane(DequeueFromProducer,带锁)——即调用线程只干自己查询的活。 - REGULAR worker 每轮先 REGULAR 队列后 ASYNC 队列,所以 I/O 活在计算池空闲时也会被计算线程顺手做掉;ASYNC 线程从不碰计算 task。
v2.0 之前的旧算法(已删除):worker 用 token-less try_dequeue(item),从链表头(最新的 producer)往后扫,只看前 3 个非空 lane、挑 size_approx 最大的取 1 个,调用之间不保留状态。提交 0f67e73fd31(2026-10-09,PR #26809「…use a ConsumerToken to improve query execution fairness」;同期由外部用户以 issue #26818「Task Scheduler is Unfair: Always Prioritize 3 Queries Only」独立复现)的说明原文指出:因为只扫前 3 条、且新查询不断让自己的 lane 非空,任何时刻只有约 3 条查询能拿到后台 worker,老查询的 task 永远取不到,只被轮询的查询可能完全没进展——这正是改成 ConsumerToken 轮转、并把配额从 256 降到 16 的原因(256 步比一个查询的总步数还多,等于不生效)。
3.4 异步 I/O 与 read-ahead(v2.0 新增)
- 扫描 I/O 下放到 ASYNC 池:Parquet reader 把列块读取包装成异步任务,返回
AsyncResult(io_tasks, ASYNC)(parquet_reader.cpp:2363、:2488);扫描 task 先挂起(BLOCKED),I/O 全部完成后被唤醒继续解码。 - read-ahead:
read_ahead_depth默认 -1(自动),深度不限,积压量由临时内存预算(ManagedAsyncMemoryGovernor)兜住;设 0 关闭;async_threads=0时也自动关闭(scan_read_ahead.cpp:144)。开启后会在 ASYNC 池上提前打开后续文件、提前调度后续 row group 的 I/O。 - 写:
COPY ... TO的文件打开/关闭/收尾作为生命周期任务投到 ASYNC 池(physical_copy_to_file.cpp:318);AsyncWriteQueue的落盘同样走 ASYNC 池。
附录:从 v1.5 到 v2.0 改了什么
这些笔记最早按 v1.5.x 写,2026-11-04 按 v2.0.0 源码重核后改了下面 9 处:1–4 在 v1.5 时代成立,是 v2.0 改掉的——async_threads(204c01453f9,2026-05-29)、read-ahead(721de15a36d,2026-08-14)、轮转取 task(0f67e73fd31,2026-10-09)三个提交都不在 v1.5.6、在 v2.0.0 里(git merge-base --is-ancestor 核对);5–9 是旧版本身不准确、已过时或缺失:
| # | 旧说法 | 现在(源码) |
|---|---|---|
| 1 | 一个 TaskScheduler + 一个队列 + 一个 worker 池 |
两个池两个队列(REGULAR + ASYNC),REGULAR worker 两个队列都取 |
| 2 | worker 用 token-less try_dequeue,前 3 个非空 lane 里挑最满的 |
ConsumerToken 轮转,每条 lane 取满 16 个整体换 lane(0f67e73fd31);旧算法会饿死老查询 |
| 3 | 无公平 | 有”轮得到”的轮转公平;仍无优先级、无抢占 |
| 4 | 阻塞等 I/O 只靠 Deschedule | Parquet 读 I/O、文件打开/关闭、写落盘下放到 ASYNC 池;扫描默认开 read-ahead |
| 5 | Finalize 由最后完成的 worker 当场执行 | 最后一个 task 只负责触发;Finalize 是新投进 lane 的 1 个 PipelineFinishTask,谁取到谁跑 |
| 6 | PG 池 pg_connection_limit=64、超限直接抛错不排队 |
选项已弃用;新池默认 force 无视上限,pg_pool_max_connections 默认 clamp(核数×1.5, 4, 32) 且只管缓存数;wait 模式才排队(30s 超时) |
| 7 | (无)DuckLake 层的线程模型 | 新增第 6 篇 |
| 8 | 开更多连接不会增加 CPU,所有连接共用一个 threads 大小的池 |
后台 worker 是 threads − 1 个;每个活跃连接的调用线程还会循环执行自己查询的 task(client_context_execution.cpp:349) |
| 9 | 文件清单在 planning 阶段对 catalog 发 SQL 取得 | 扫描所在 pipeline 被调度时,在 InitializeGlobalState 里单线程物化(ducklake_multi_file_reader.cpp:288) |
图与动画:第 3–6 篇里的 7 张图都按上表重画过;旧版画的是 v1.5 的调度器和「planning 阶段取清单」。
仍待核实:Connection::Query 从 worker 线程发起时具体怎么驱动内部查询的 Executor(第 6 篇里相关两句是推断);默认 force 模式下 PG 服务端拒连的实际表现(第 6 节失败链第 ④ 步是推断)。