
从这一篇开始进入引擎内部。第 3–6 篇回答同一个问题:一个应用用多个连接,同时往同一个 DuckDB(挂着 DuckLake)发查询时,引擎内部到底是谁在干活。
适用范围:源码 DuckDB v2.0.0(
duckdb/tagv2.0.0)、DuckLakev2.0-cyanoptera@c506b268、duckdb-postgresmain @2a1871d(连接池在子模块database-connector@c305670);官方文档引用lts/stable。
术语约定:本文的 morsel = DuckDB 官方文档所称的 row group(默认 122,880 行),二者同义;官方用户文档只用 “row group”,不用 “morsel”(后者是引擎/学术叫法)。v2.0 源码里扫描的领取单位叫 scan job,一个 job 仍是一个 row group。
可信度:关键主张均已对照源码或官方文档核验,出处汇总在第 6 篇末尾。图为宏观示意(关键框内标了源码锚点);所有图已于 2026-11-04 按 v2.0.0 源码重画,生成脚本带几何校验。
一句话主线:DuckDB 在单查询内部做极致并行;跨查询共享线程池,v2.0 起 worker 会在各查询之间轮转取 task(不再饿死老查询),但仍没有优先级、抢占和准入——多连接并发下的稳定性,还得靠应用层(比如在发起查询前用 Semaphore 限流)来兜。版本变化:这些笔记最早按 v1.5.x 写,2026-11-04 按 v2.0.0 源码重核过一遍,改了哪些见第 4 篇末尾。
0. 一张图看全:多连接并发查询总览
当一个 Java 应用用 DuckDBConnection.duplicate() 开出多个连接、并行发查询时,同一个 DuckDB 实例内部是这样处理的:
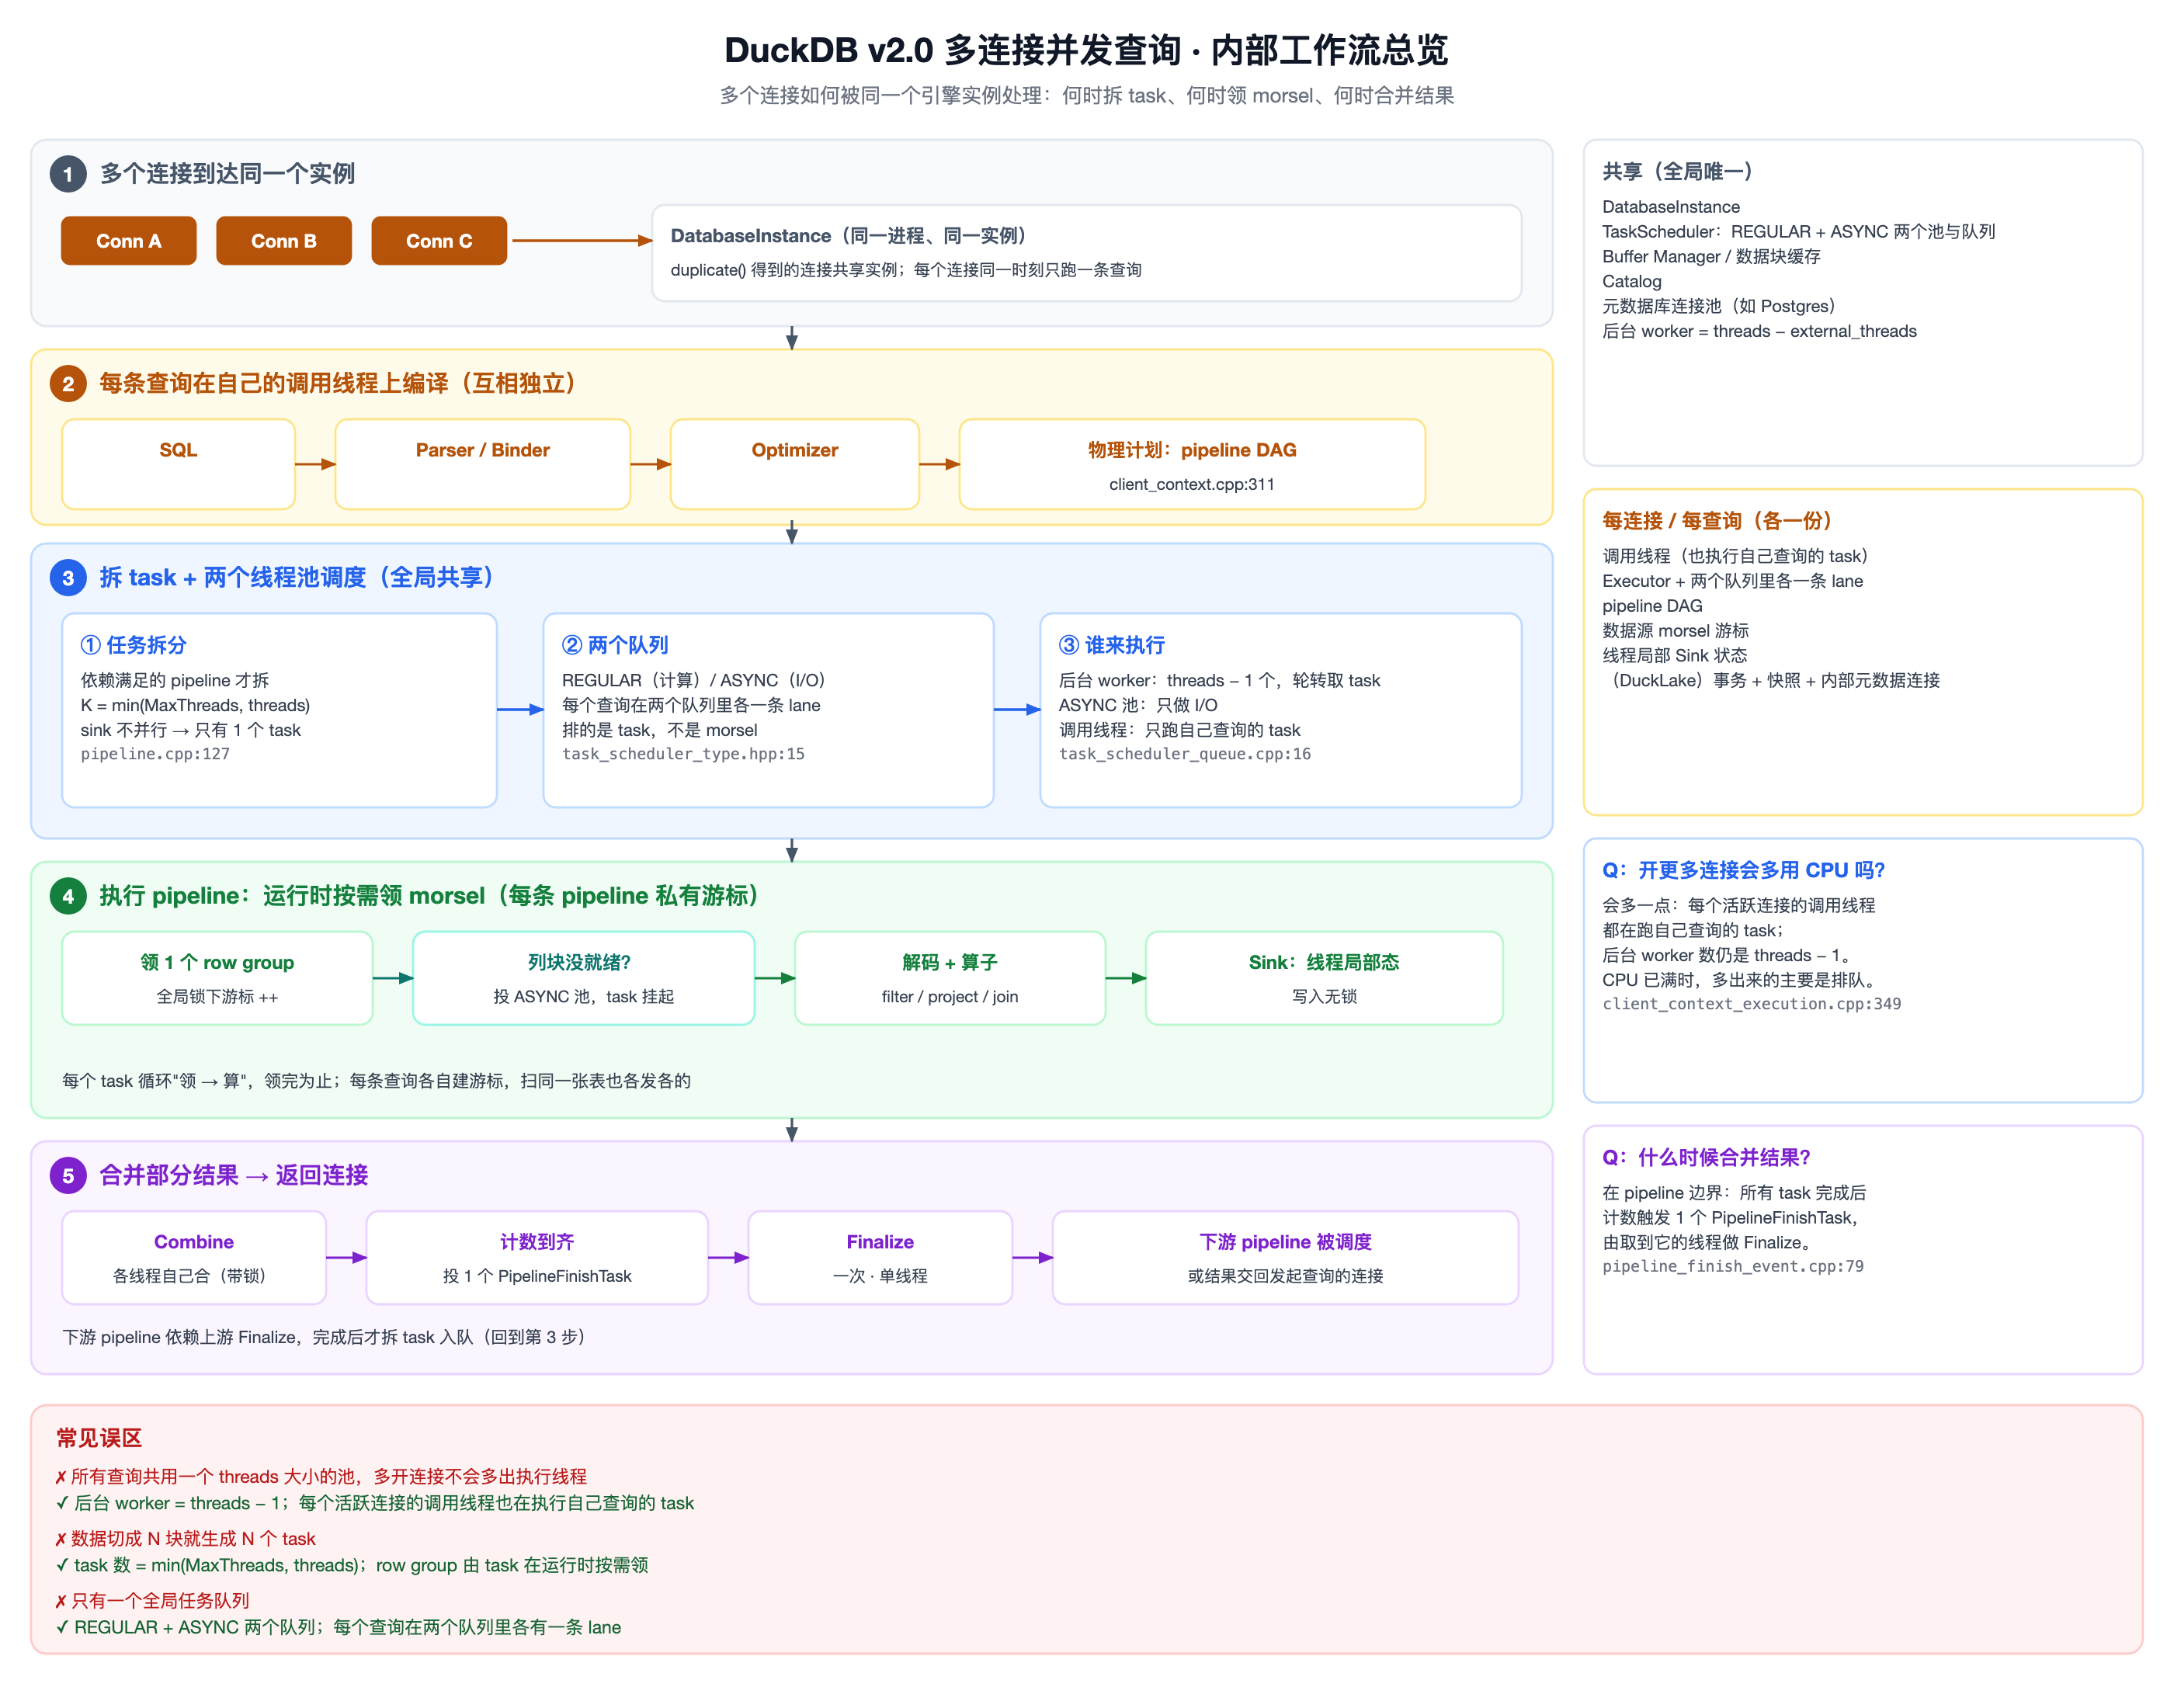
五个阶段:① 多连接到达(同一实例)→ ② 每查询各自编译 → ③ 拆任务 + 全局调度 → ④ 运行时按需拆 morsel → ⑤ 合并结果返回各自连接。下面逐层展开。
1. 前提:duplicate() 多连接 = 同一个引擎实例
duplicate()创建的是共享同一个DatabaseInstance的新连接——同进程、同一个 in-memory 实例、同一个 attached catalog、同一个元数据库。不是新进程、不是新 DB。- 单个连接同一时刻只处理一条查询(
ClientContext有锁,串行)。所以要真正并行,必须开多个连接——这正是用duplicate()的原因。 - 共享(全局唯一):
DatabaseInstance、两个线程池(REGULAR 计算池 + ASYNC I/O 池)及各自的任务队列、Buffer Manager / 块缓存、Catalog、元数据库连接池。 - 每连接 / 每查询(各一份):
Executor+ producer lane、pipeline DAG、数据源 morsel 游标、线程局部 Sink 状态、(DuckLake)事务 + 快照 + 一条内部元数据连接。
关键推论:后台 worker 只有
threads − external_threads(默认threads − 1)个,所有连接共用;但每个活跃连接的调用线程也在循环执行自己查询的 task(client_context_execution.cpp:349→executor.cpp:444)。所以 N 个并发连接最多是”后台 worker + N 条调用线程”同时在跑——多开连接会多出执行线程,但总吞吐仍被核数封顶,CPU 满了多出来的只是排队。多连接主要在非 CPU 瓶颈(如网络/IO 等待)时提高吞吐。
2. 从 SQL 到结果:线程分工(谁在哪个线程跑)
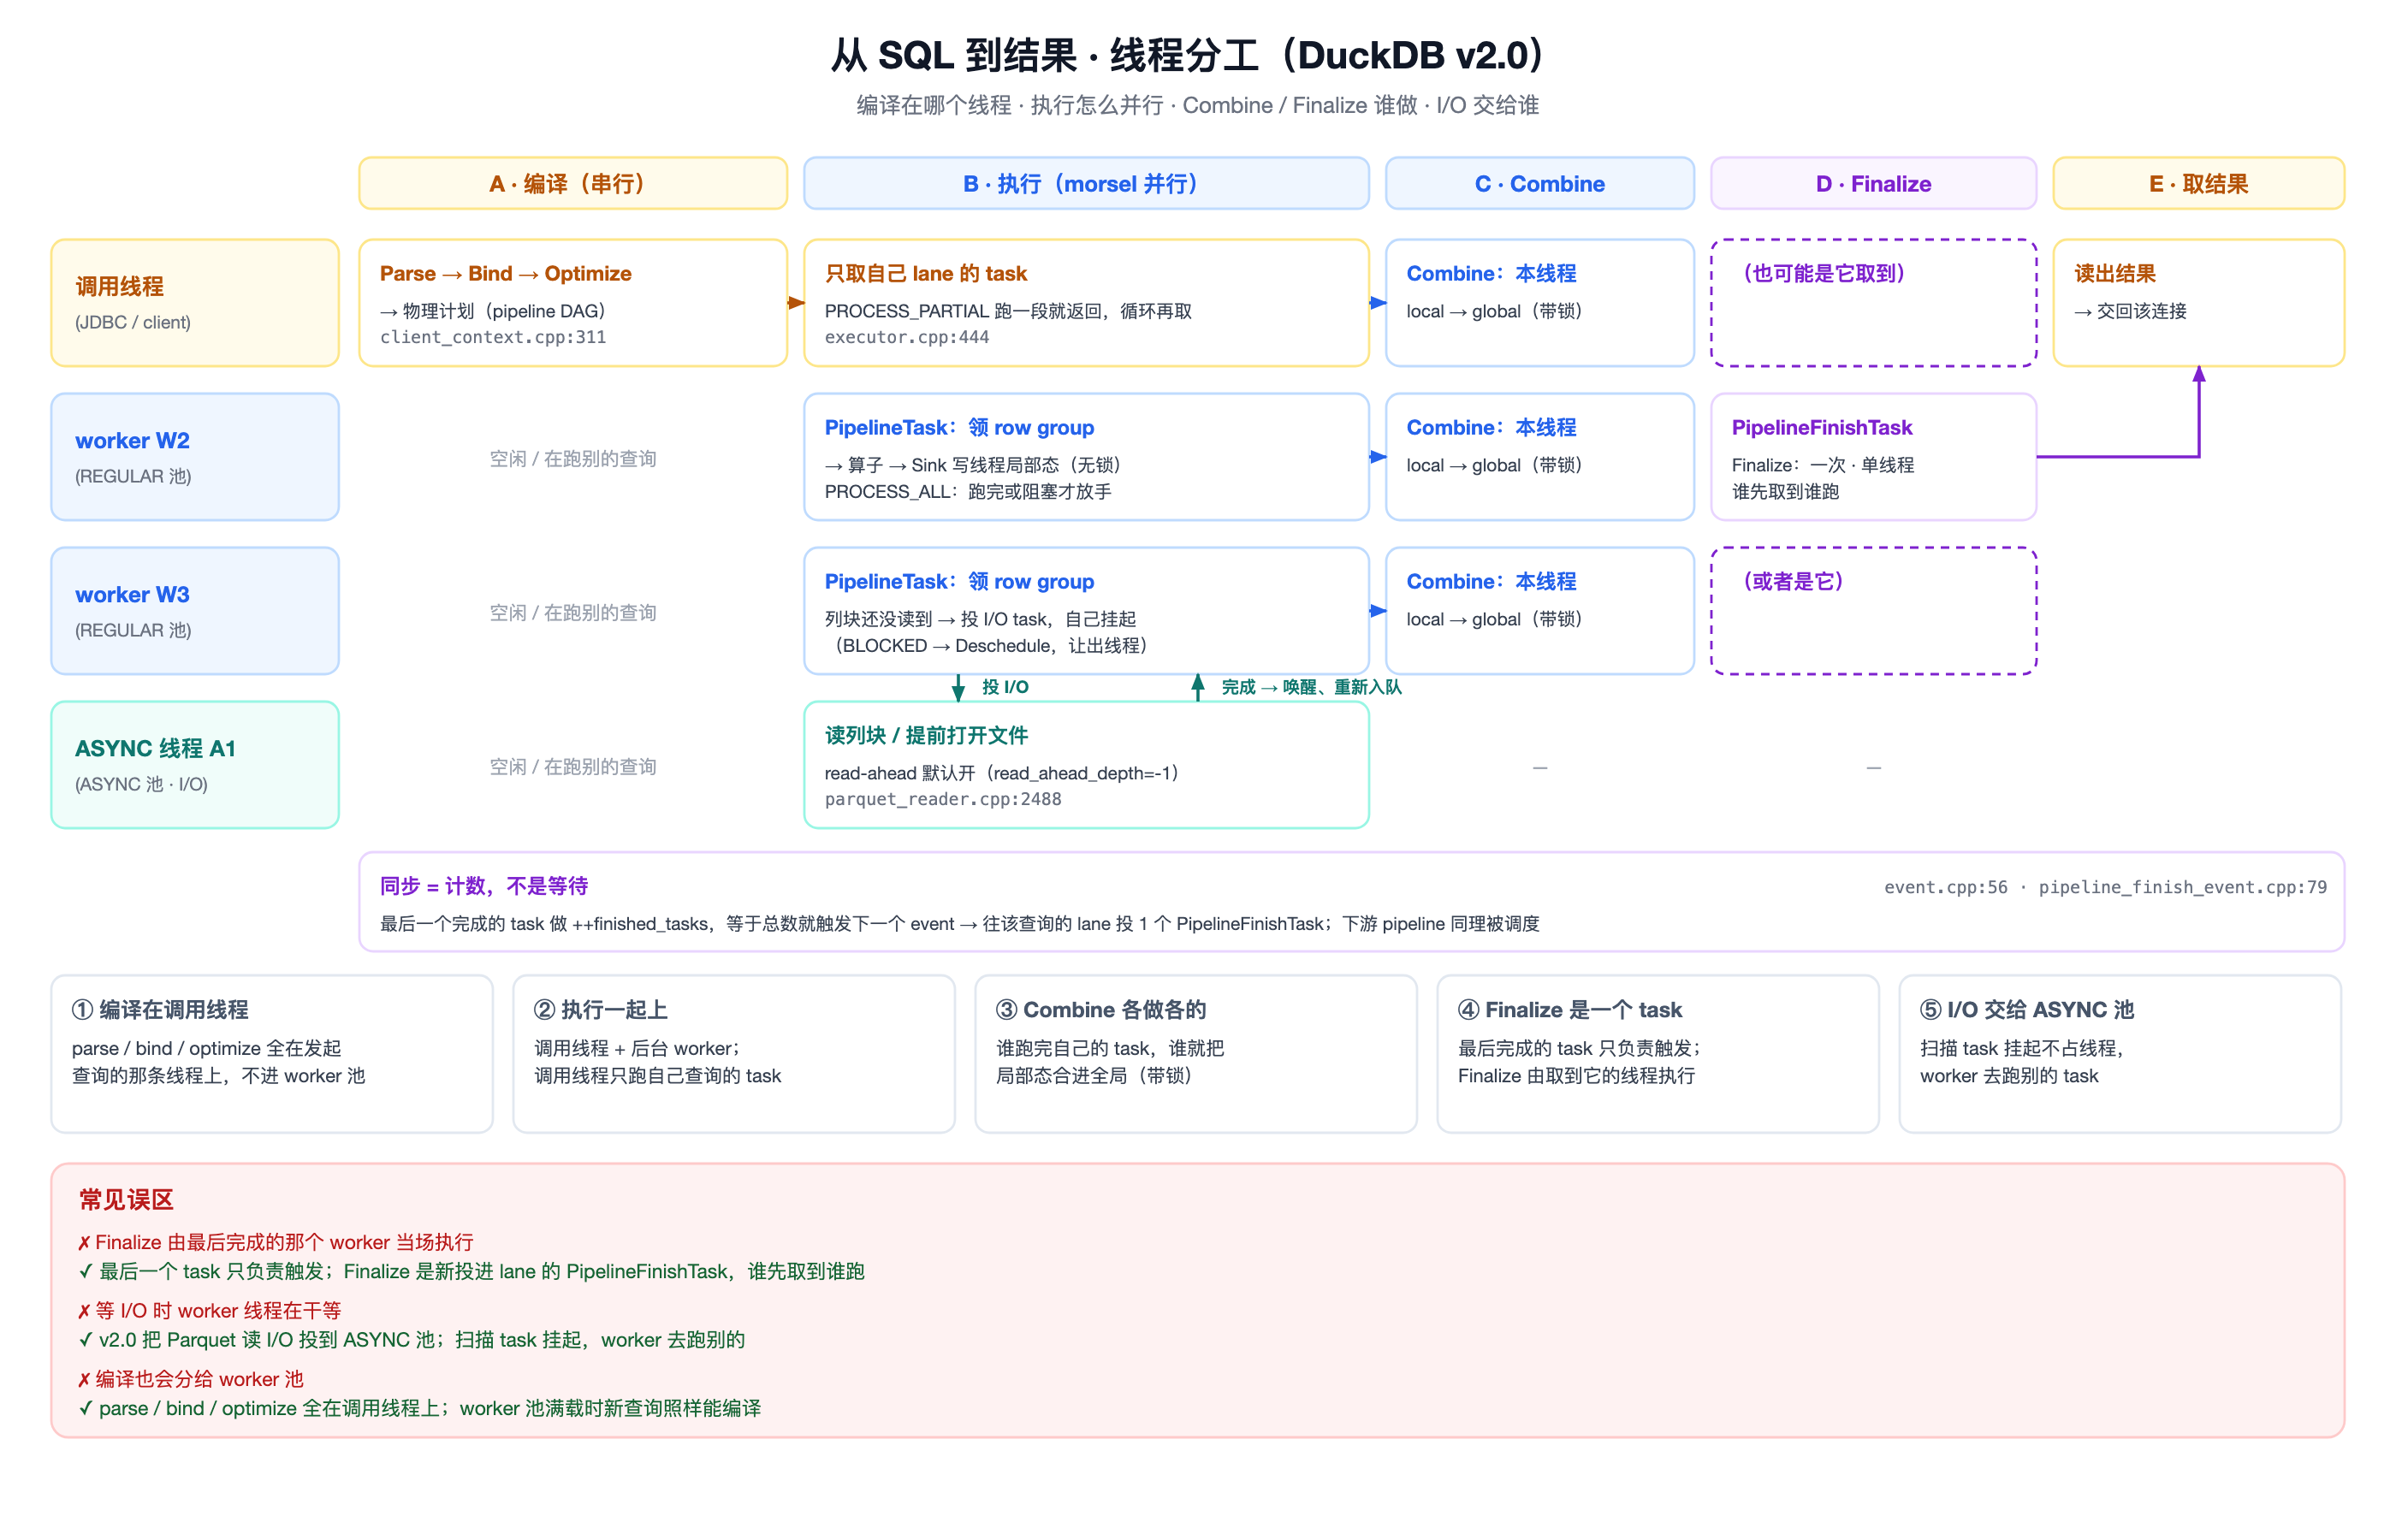
- A 编译(parse / bind / optimize / 物理计划):只在发起查询的那条连接自己的线程上、顺序、单线程完成(
client_context.cpp:311的CreatePreparedStatementInternal,在ClientContextLock下内联执行,不派发给 worker 池)。所以 worker 池即使满载,新查询照样能在自己线程上编译——被卡住的是执行,不是编译。 - B 执行:调用线程 + 后台 worker 一起跑;一条可跑 pipeline 拆成
min(source 的 MaxThreads, threads)个 PipelineTask(pipeline.cpp:127、:330)。只要 sink 不是 ParallelSink、或中间任一算子不是 ParallelOperator,整条 pipeline 就只有 1 个 task。 每个线程维护自己的 thread-local Sink 状态(如局部哈希表),写入无锁。threads= 后台 worker 数 +external_threads(默认 1,就是调用线程)。- 调用线程只取自己查询那条 lane 的 task,用
PROCESS_PARTIAL跑一段就返回(executor.cpp:444);后台 worker 用PROCESS_ALL,一个 task 跑到完或阻塞才放手(scheduler_process_partial默认 false)。
- C Combine:每个 worker 各做各的——谁跑完自己那个 task,就在自己线程上把”自己那份局部态”合并进全局态(
pipeline_executor.cpp:702,合并进全局时带锁)。不是”大家等齐再一起 combine”。 - D Finalize:全部 task 完成后跑一次、单线程。最后一个完成的 task 做
++finished_tasks,达到总数就触发 event 完成(event.cpp:56),由下一个 event 往该查询的 lane 里投 1 个PipelineFinishTask(pipeline_finish_event.cpp:79),谁先取到谁执行——可能是任意 worker,也可能是调用线程。没有固定的”合并线程”,也不是由最后完成的那个 worker 当场顺手执行。 - 同步 = 计数,不是等待:没有 worker 阻塞等别人,靠 event 计数器推进 DAG。
worker 的一生:拿到一个 task → 领 morsel、算、写线程局部态 → 该 pipeline 的 morsel 领完 → 自己 Combine 进全局 → 立刻回队列 pick 下一个 task。全程不空等其它线程。 中途若阻塞,task 返回
TASK_BLOCKED→ Deschedule 让出线程,被唤醒后重新入队。v2.0 起 Parquet 读 I/O、文件打开/关闭、写缓冲落盘会投到 ASYNC 池去做,计算线程只在 I/O 没回来时挂起这个 task(见第 4 篇 3.4 节)。