
调度器保证每个查询「轮得到」,但不限制并发、也不管内存。这一篇讲大查询为什么吃内存,以及为什么并发控制只能放在应用层。
4. 内存模型:为什么”大查询”吃内存
一个常见误区:”既然扫描拆成 row group、还按 2048 行 vector 处理,那每条查询内存应该都很小?”——不对。
- 拆 row group 只管”输入流量”:纯”扫→过滤→吐结果”的流式查询,内存确实很小、跟表多大无关。这是小查询。
- **吃内存的是”算子攒的中间状态”**,跟 row group 无关:
这些是 pipeline breaker(屏障算子):得吃完所有 morsel 才能出结果,吃的过程中那块状态一直长大。同一张大表,一个查询几乎不占内存、一个占几个 GB,差别全在”攒不攒状态、攒多大”。算子 攒什么 内存 ∝ GROUP BY / 聚合 哈希表(每分组一行) 分组数(高基数=巨大) JOIN(hash join) build 侧整表进哈希表 build 表大小 ORDER BY / 排序 待排数据先收集 待排行数 DISTINCT / 窗口 / PIVOT 去重 / 窗口缓冲 数据量 - 并行会放大峰值:每个 worker 各攒一份 thread-local 状态,再 Combine → 线程越多、聚合/排序类查询内存峰值越高(这正是官方 OOM 文档建议”降
threads防 OOM”的原因)。 - spill 兜底:状态超过可用内存时,DuckDB 把哈希表/排序缓冲落盘继续算(out-of-core),慢但不崩。
- 两个默认值要记住:
threads默认 = 逻辑核数(std::thread::hardware_concurrency(),含超线程);memory_limit默认 = 80% 可用内存(config.cpp:646),但只对 buffer manager 生效——有些算子绕过 buffer manager,能占超过 limit 的内存,所以高并发下仍可能真 OOM(官方甚至建议把 limit 调到 80% 以下防 OOM)。
6. 并发与容量:引擎不做准入,靠应用层
DuckDB 没有内置的”最大并发查询数 / 准入控制”——threads 只管单查询并行度、不管查询准入。不控并发会怎样,对比如下:
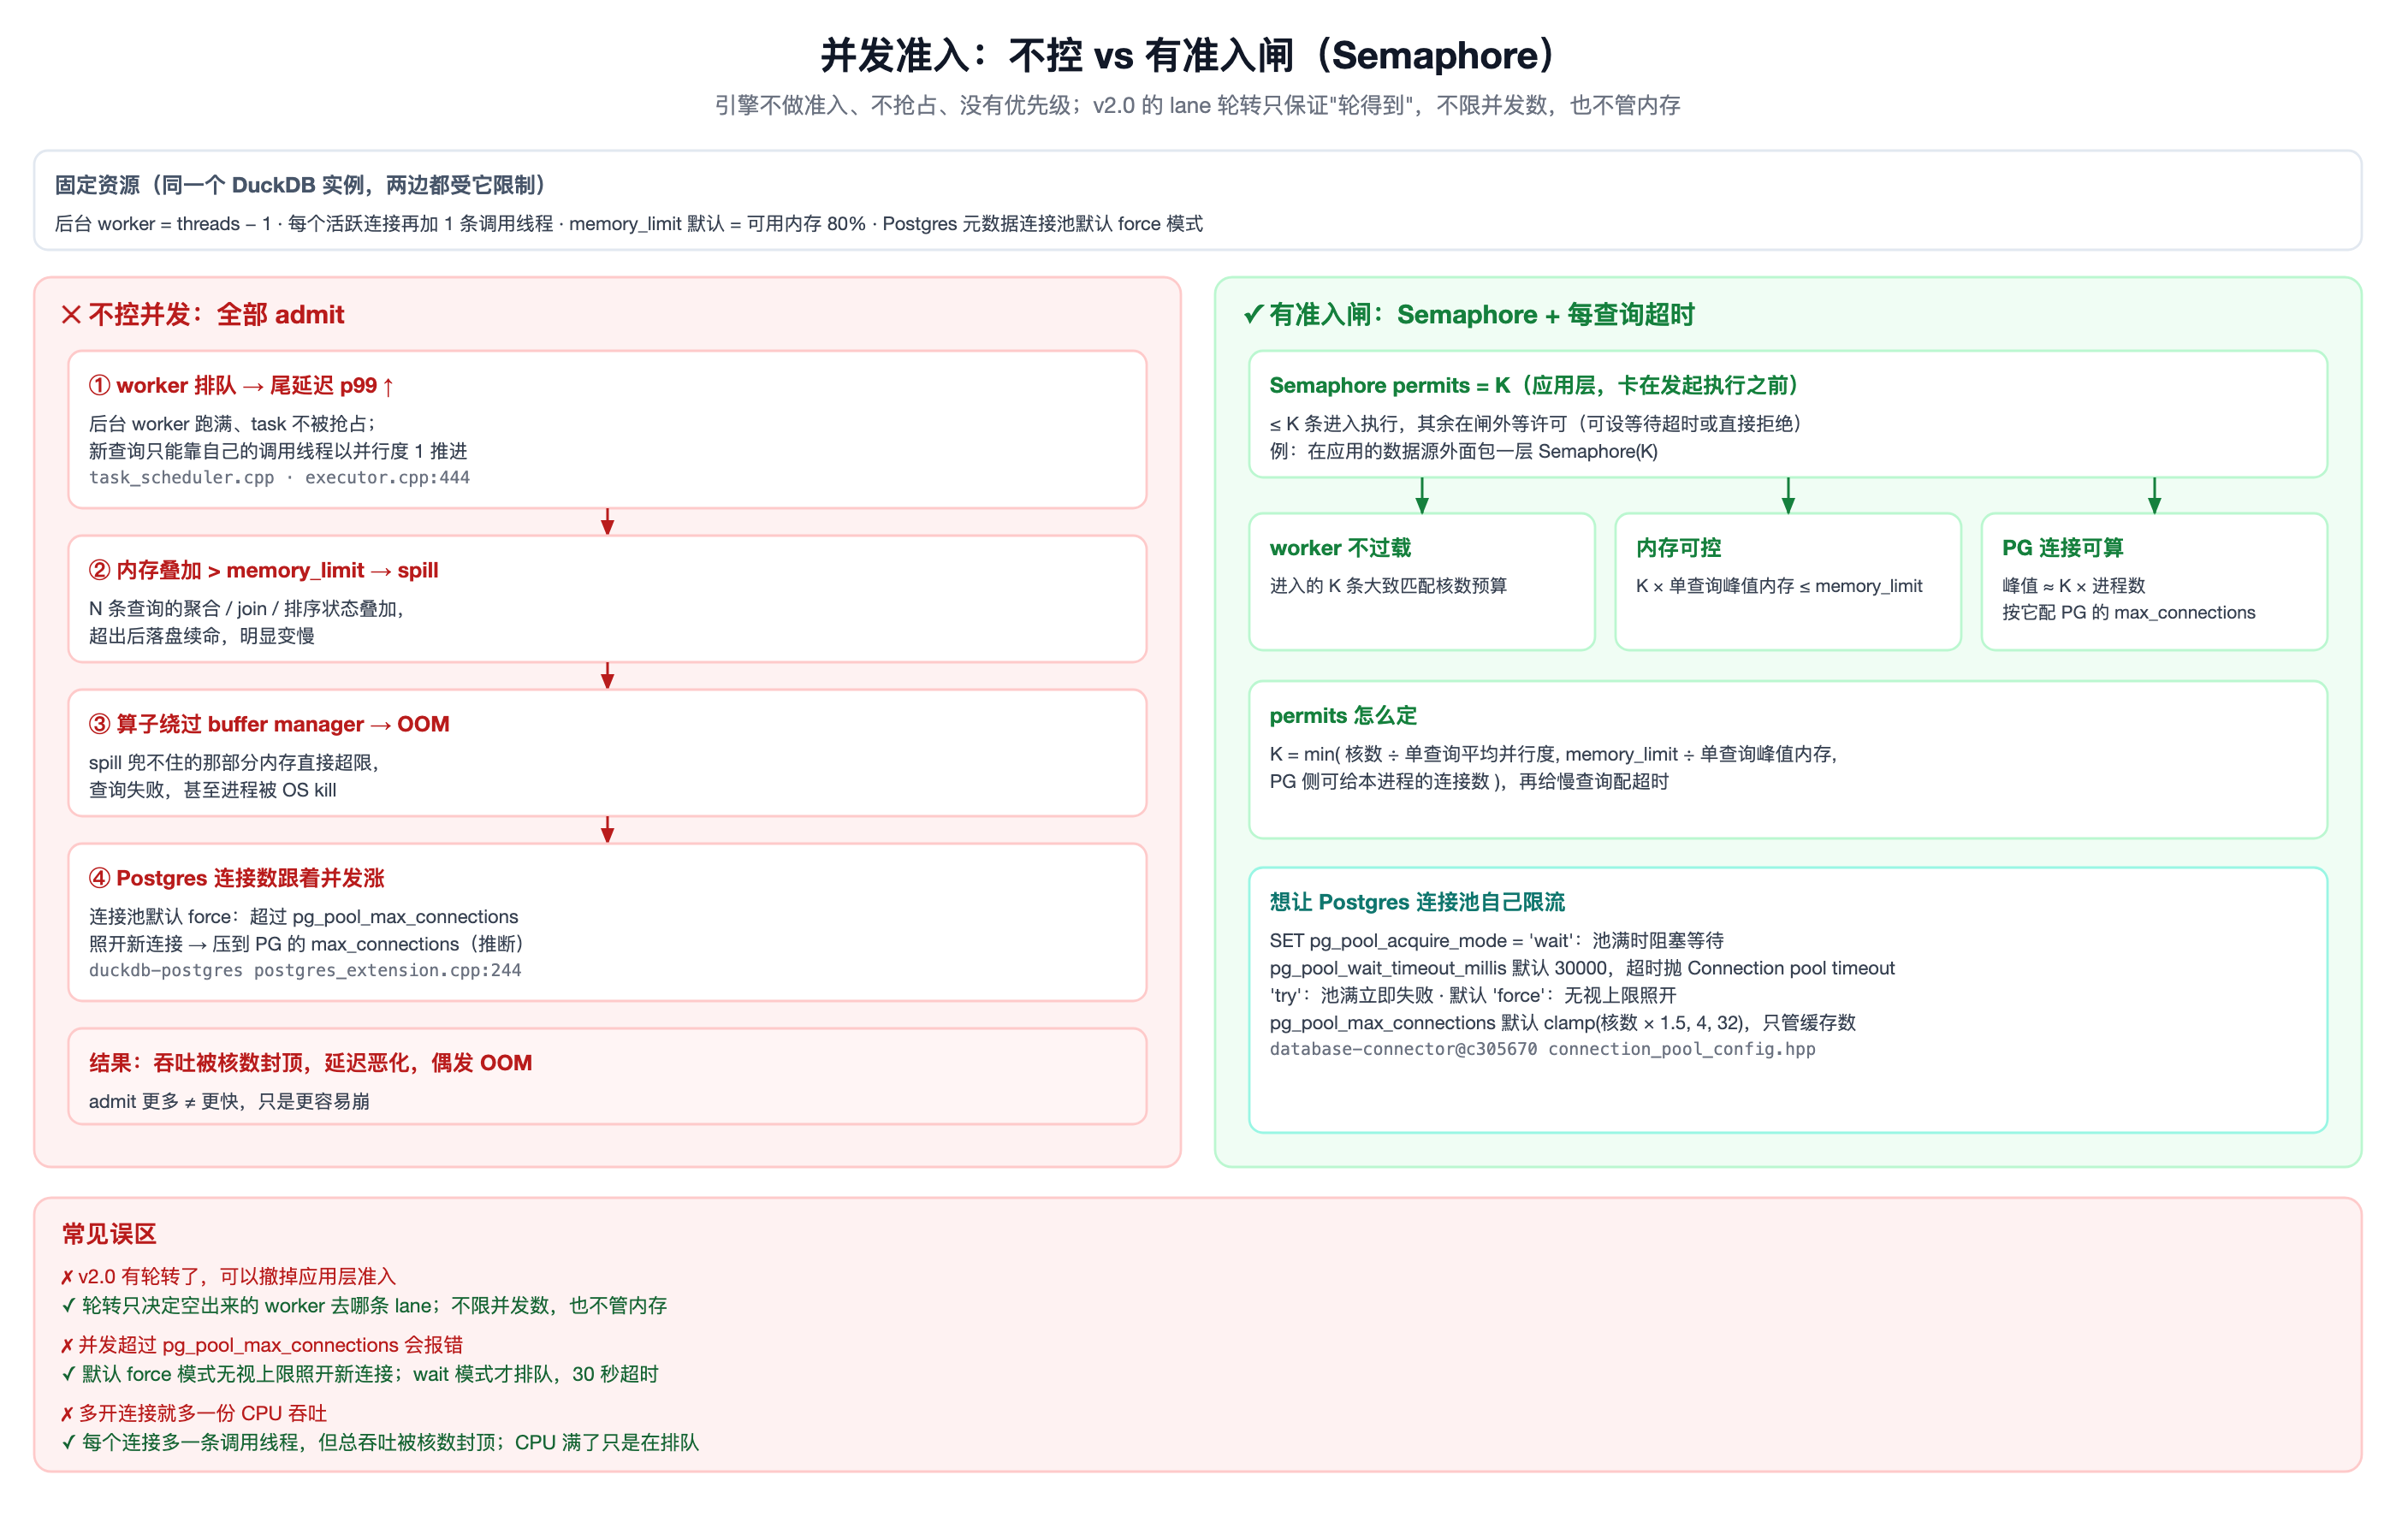
- 不控(左)失败链:全 admit → ① worker 排队(尾延迟 p99 ↑)→ ② 内存叠加超
memory_limit(spill)→ ③ 绕过 buffer manager(OOM)→ ④ 并发连接数压到 Postgres(默认force模式下池不拦,最终由 PG 服务端的max_connections拒绝——推断,未实测)。admit 更多 ≠ 更快,只是更容易崩。 - 有准入闸(右):
Semaphore permits=K卡在发起执行前(应用层)→ ≤K 进入、其余等许可 → worker/内存/PG 都可控 + 每查询超时。
permits 怎么定:
1 | K = min( 核数 ÷ 单查询平均并行度, memory_limit ÷ 单查询峰值内存, PG 侧可给本进程的连接数 ) |
并给慢查询配超时兜底。
一个调参例子(并发上限 4→6,8GB 内存、threads=8 的机器):
- BI 负载 = 大量小查询 + 少量大查询。permits=4 会队头阻塞——1–2 条大查询占住槽位,一屏 dashboard 十几条小查询全堵在
getConnection()。放到 6 让小查询从大查询旁边溜过去。 - 内存账:
6 × ~1.3GB 均摊 ≈ 8GB,仍在 limit 内(8÷6≈1.3);小查询远用不满、有富余;真有大查询超过它那份,靠 spill 兜底(落盘续命,不 OOM)。所以”6 并发 + 8GB”这套在内存上是稳的。 - 为什么不撤掉这个 Semaphore:引擎没有 per-query 优先级、没有抢占,v2.0 的 lane 轮转只保证”轮得到”,不限制并发和内存,所以它仍是唯一的准入/内存杠杆——只能调宽,不能撤。
并发 6 ≤ threads 8,不超编(并发超过 threads 没有 CPU 收益)。
6.1 Postgres 元数据连接池
DuckLake 用 Postgres 当 catalog 时,走 DuckDB postgres 扩展;连接池实现已抽到子模块 database-connector(dbconnector::pool::ConnectionPool),扩展里只剩配置映射(duckdb-postgres/src/storage/postgres_connection_pool.cpp:49 CreateConfig)。
- 池归属 per-ATTACH(每个 attached PG 库一个池);一个进程内所有 DuckLake 元数据流量共用这一个池。
- 默认值(
database-connector@c305670的connection_pool_config.hpp):设置 默认 含义 pg_pool_acquire_modeforce池满也直接新建连接、无视上限; wait= 阻塞等待到超时;try= 立即失败pg_pool_max_connectionsclamp(核数 × 1.5, 4, 32)池里缓存的连接数上限,不是硬并发上限(选项说明原文:”并行扫描时可以暂时超出”);设 0 = 不池化 pg_pool_wait_timeout_millis30000 仅 wait模式:等满 30s 抛 “Connection pool timeout”pg_pool_idle_timeout_millis60000 空闲连接回收 pg_pool_enable_reaper_threadtrue 起后台 reaper 线程清理空闲连接(不属于 DuckDB 的线程池) pg_pool_health_check_querySELECT 1归还/复用时的健康检查 - 旧选项已弃用:
pg_connection_limit→ 改用pg_pool_max_connections;pg_connection_cache→ 改用pg_pool_max_connections=0关闭池化(duckdb-postgres/src/postgres_extension.cpp:176、:194)。 - 超限行为:默认
force模式下,池这一层不报错也不排队,并发多少就开多少连接。要让池真正限流,得显式SET pg_pool_acquire_mode='wait'。 - 容量换算:默认
force下,PG 端实际要扛峰值并发 PG 事务数 × 进程数条连接,而不是max_connections × 进程数。多进程部署要按峰值算 PG 的max_connections,或前置 PgBouncer;应用层 Semaphore 的许可数实际上就是这道上限。